
 神经网络与深度学习
# 机器学习基础
简而言之,就是让机器调整非线性函数参数,通过不断喂数据集,校正参数拟合一条符合当前数据集的函数,这一过程称之为“学习”
# 机器学习概述
# 机器学习
机器学习步骤:数据预处理,特征提取,特征转换,预测
- 中间两步又可被视作特征工程
机器学习的三个基本要素
- 模型:具有内部参数权重 w 和偏置 b
- 学习准则:损失函数和风险最小化准则
- 优化算法:最小二乘法,梯度下降法
损失函数:在确定模型参数 w 和 b 时,力求使损失函数最小化
- 0/1 损失函数:预测和 y 不同即为 0,否则为 1
- 平方损失函数:
- 交叉熵损失函数:
期望风险、经验风险和结构风险:又叫期望错误,就是应用在机器学习上模型上的某种损失函数,在学习过程要求通过找到合适的参数将这种风险(错误)实现最小化,也就是所谓的风险最小化准则
- 梯度下降法:
,其中 α 为学习率 - 提前停止:为了防止过拟合,提前停止梯度下降,当然,也可以加入正则项使其转化为结构风险最小化问题防止过拟合
机器学习算法的类型
- 监督学习(输入有标签):算法如线性模型,神经网络
- 无监督学习(输入无标签):算法如主成分分析,自编码器
- 强化学习(通过交互学习)
介于监督学习和无监督学习之间,还有半监督学习,或弱监督学习,其采用一部分有标签的训练集训练出一个基础的模型,再通过这个基础的模型预测无标签数据得到有标签的训练集,选取可靠的部分再作为训练集训练自身(这种方式也叫自训练)
理论和定理
- PAC 学习理论:可能近似正确,在误差足够小时认为正确
- 没有免费午餐定理:没有一种模型能高效解决所有问题
- 奥卡姆剃刀原理:追求简单的模型
- 丑小鸭定理:模型的差异不可简单量化
参数和超参数:模型的参数指其内部参数,如权重 w 和偏置 b,影响模型效率的参数;模型的超参数指描述模型结构的参数,如神经网络的层数,不可通过优化算法优化,需要强经验调整
# 表示学习
表示学习用以特征提取,将输入变为更有效的特征,主要需要解决语义鸿沟问题
一个好的表示
- 强的表达能力
- 简化后续任务
- 独立性和迁移性
表示学习可以分为
- 局部表示(one-hot 表示):离散的表示
- 分布式表示(如 RGB 颜色,即为三位稠密分布式表示):多维低维稠密向量
表示学习的目的:构建多层次的特征表示(高维到低维的映射)
# 深度学习
从数据中自动学习到有效的特征表示,主要需要解决各层之间贡献度分配问题,多采用多层神经网络的反向传播算法
从表示学习中,我们可以构建一个多层次的特征表示,深度学习通过多个特征表示,自动学习到有效的特征表示,即为能解决实际问题的模型(预测函数)
端到端学习:和模块化对立,只关注最开始的输入和最后的输出,中间的过程不加以区分
# 线性模型
# 线性回归
属于二分类问题,分为简单回归(输出为 0/1)和多元回归(分为多类)
参数学习:学习合适的权重 w 和偏移 b
- 经验风险最小化:最小二乘法,梯度下降法
- 结构风险最小化:正则化,梯度下降法
- 最大似然估计
- 最大后验估计:贝叶斯估计
# 感知器
是一种线性分类器,只有一个神经元,输出是与不是(1/0),感知器学习算法其实是一个经典的线性参数学习算法(使用梯度下降法求解)
参数学习的梯度下降递归公式
其中每一次迭代的梯度为 -xy,学习率 α 为 1
感知器的收敛性,求得最大的特征向量的模 R 和最小的函数值
则感知器一定会在
次迭代中收敛(即完成参数学习),若这么多次都未收敛,则可以判定其线性不可分
参数平均的感知器:用以解决参数学习中,输入样例顺序造成的强干扰,简单来说,就是令后学习的样例的学习率降低,能够有效提高感知器的泛化能力
改进的平均感知器参数学习算法
其中 u 即为平均感知器,t 为当前的迭代次数
# 支持向量机
解决二分类问题(线性模型)的经典算法,就是寻找一个使输入 x 间隔最大的超平面(间隔越大,二分划分就越稳定,这很显然)
需要注意的是,这个间隔最大的超平面具有唯一性,间隔公式为
位于超平面上的样本,称之为支持向量
支持向量机的优化(参数学习)是一个凸优化问题
- 参数学习:对模型做出强烈假设,固定参数个数
- 非参数学习:没有固定参数,在学习过程中动态加入参数
支持向量机的决策函数只取决于支持向量的数量,也就是说支持向量机的收敛效率只取决于支持向量
# 神经网络
非线性的模型,凹优化问题,没有足够的数学理论支撑
# 前馈神经网络
前馈神经网络分为:全连接神经网络;卷积神经网络
就是一个多层感知器(感知器:线性分类器,只有一个神经元)
- 净输入
- 活性值
- 激活函数
为什么是前馈,上一层感知器的活性值为下一层感知器的输入,经过当前层的加权变换后为净活性值,再经过当前层的激活函数作为新的活性值输入至下一层感知器
激活函数
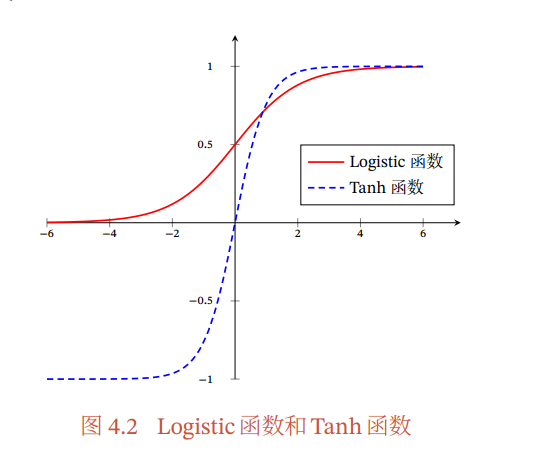
Sigmoid 函数:分为 Logistic 和 Tanh 函数,前者非零中心化,后者为零中心化
ReLU 函数:一个分段函数,会发生 ReLU 死亡现象(就是在迭代过程中 x 一直小于 0,ReLU 始终为 0,不被触发,就像不存在一样),和梯度消失有点像
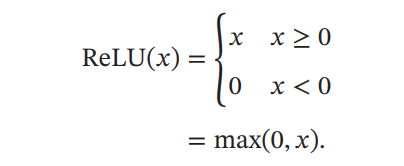
反向传播算法:通过激活函数的偏导数,将当前层的活性值反向输入给上一层,这自然有可能造成梯度消失问题
所谓梯度消失,就是当输出乘以导数(很小的值),导致结果越来越小,直到梯度近似为 0,就像消失了一样,这将对神经网络造成严重的计算负担
如何解决梯度消失问题:采用导数较大的激活函数如 ReLU
自动梯度计算
- 数值微分:根据导函数定义,手动设置 ▲x 为一个很小的值,直接求▲y
- 符号微分:保留符号(未知数)进行微分,微分对象为含未知数的多项式
- 自动微分:处理一个函数或一段程序
# 卷积
前馈神经网络的一种,全连接神经网络中,每一层感知器都有其权重和偏移,当层数增加时这样的系数将呈指数增加,大大降低了计算效率
于是就有了卷积神经网络,其特征为权值共享、局部连接、汇聚,其结构由卷积层、汇聚层、全连接层构成
信号序列 x 和滤波器 w 的乘积之和即为卷积
卷积常作为特征提取的方法,其结果为特征映射(这里涉及到机器学习的中间两个步骤)
卷积良好的数学性质:交换性和导数
# 循环神经网络
不同于前馈神经网络的单向传播(从上一层传向下一层直到全连接层),循环神经网络通过随时间反向传播算法可以将错误反向传播给前驱,使神经网络具有短期记忆能力
# 网络优化和正则化
常见的优化方向
- 梯度下降批量选择:常采用小批量梯度下降法
- 学习率调整:学习率衰减,学习率预热,学习率周期调整(加大)
- 梯度估计修正
# RMSprop 算法
用于学习率调整
先计算参数梯度的累计值,其中 gt 为本次迭代的梯度,β 为衰减率(常为 0.9)
通过累计值(作为系数)调整本次梯度
下一轮的学习率即为
在学习率调整中,这个 θ 即为学习率 α,代入即可
AdaGrad 算法:和 RMSprop 的区别就是 Gt 的求法不一样,其 Gt 简单的为每个参数梯度平方的累计值
# 动量法
用于梯度估计修正,在梯度下降的时候,常采用随机梯度下降,为了避免梯度不合理,采用平均值来处理当前梯度(防止梯度消失或爆炸)
原梯度为偏导数,通过加权移动平均更新为
其中 ρ 为动量因子,常为 0.9,α 为模型当前的学习率
自然,θ 作用于参数学习的话,如权重 w,下一个值即为
# 逐层归一化
再参数化的一种
归一化:即将模型的输入经过多一层处理,使之规范且合理
批归一化(批量归一化):针对神经网络中某一层中的单个神经元,对其输入进行归一化处理
层归一化:对神经网络的某一层的所有神经元进行归一化处理
# 网络正则化
# 记忆与注意力机制
《Attention Is All You Need》
# 注意力机制
全连接前馈神经网络的输入和参数太过庞大,每一层每一维都需要不同的参数参与,于是采用卷积前馈神经网络对参数的数量进行简化(权重共享、局部连接、汇聚),但这似乎还是不够
于是对于输入向量 X,我们采用注意力机制,即规定一个任务向量,规定需要直接作用于当前任务的维度,使神经网络重点处理和当前任务强相关的维度数据,这就是所谓注意力机制
# 无监督学习与自编码器
自编码器:是通过无监督的方式来学习一组数据的有效编码(或表示)
就是一个编码和解码的过程,其要学习的风险函数为编码再解码的差错率,设函数 f 为编码函数,g 为解码函数,则期望风险为
通过风险最小化准则,将编码和解码函数拟合为理想值,实现无监督的机器学习
# 集成学习和 AdaBoost 算法
就是集合多个独立模型,取其“均值”作为最终的模型输出
其中 an 为各个独立模型参与集成的权重
AdaBoost 算法:求解各个模型的权值,并进一步通过权值和各个弱分类器(基分类器)构造一个强分类的算法
其中 F 即为所要求的强分类器(其实就是一个集成学习模型)
算法的基本思路是,在经过一次基本权重分配,更加注意分配错误率更高的弱分类器,适时的提高出错的弱分类器对应的权重,以此增加每个弱分类器的差距
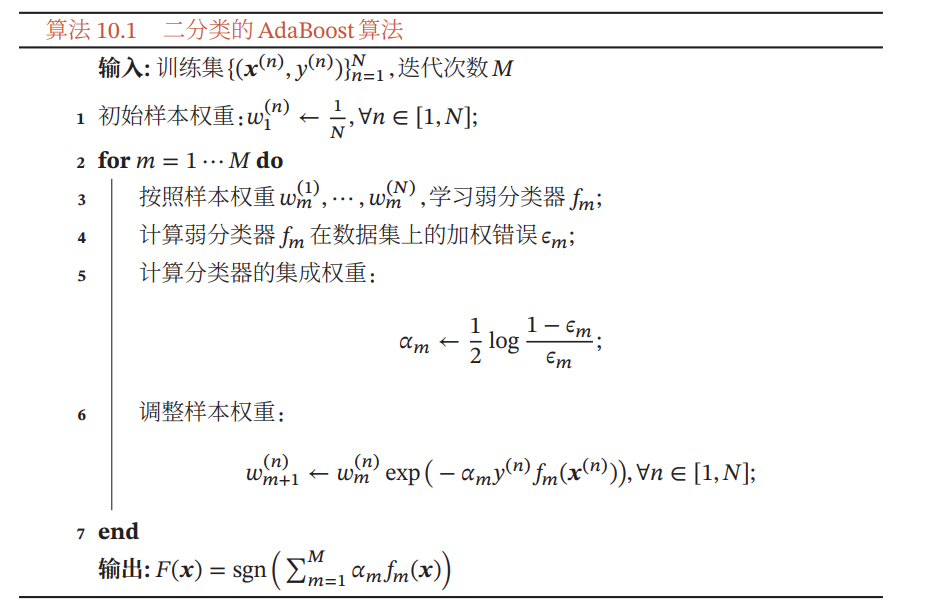
第一步:初始化各弱分类器权重,均分为 1/N
第二步:选取弱分类器 fm,并计算其加权错误 ε,通过公式为 fm 计算新的权重 αm(这取决于错误的大小,错误越大,集成权重越大)
第三步:调整弱分类器 fm 的内部参数 w 的样本权重
第四步:遍历所有弱分类器 f,循环第二步和第三步,更新所有弱分类器的集成权重 α 和内部权重 w
在二分类模型中,最后的输出为 1/0,即判断是否是这一类,所以最后的强分类器 F 要加上一个 sgn 函数,表示其正负(大于 0 则输出 1,否则输出 0)
# 深度生成模型与变分自编码器
深度生成模型是一种特殊的模型,其目的在于随机生成可观测的数据(一个数据生成器)
变分自编码器:再参数化(其实归一化属于再参数化的一种),就是将自变量用另一个函数的因变量表示,如对于函数 f(θ),其接收的输入为初始的 θ,现在我们对 x 进行这样的处理
现在函数 f 接收的参数为函数 g 的输出,这样有利于将原始自变量简化、规范化,从而减少参数量,便于计算
# 机器学习实验
# 线性回归训练与验证
实验目的和要求
- 掌握机器学习的一般实验过程
- 理解并实现线性回归模型
实验要求:学会安装和设置机器学习开发环境;熟悉机器学习任务的编码和调试
linear_regression.py
# 导包
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

#导入数据并可视化
data_set = pd.read_csv('Salary_Data.csv')
data_set = data_set.take(np.random.permutation(30))#随机排列
data_set

data_set.plot.scatter(x='YearsExperience',y='Salary')
plt.show()

data_set = np.array(data_set)
data_set

# 分割数据集为训练集和测试集
data_train,data_test = np.split(data_set,[20],)#水平切割
n_train = np.shape(data_train)[0] #训练集的个数
n_test = np.shape(data_test)[0]

x_train = data_train[:,:1]
y_train = data_train[:,1:2]

x_test = data_test[:,:1]
y_test = data_test[:,1:2]


# 列出模型 y = wx + b
#对参数进行初始化
w = np.ones(n_train).reshape(n_train,1) #20列1行的矩阵
b = 1.0

lr = 0.00001 #学习率

num_iter = 100000 #迭代次数


# 使用梯度下降求解参数
for i in range(num_iter):
    y_hat = w*x_train + b       #y_hat是预测值
    sum_w = np.sum((y_train-y_hat)*(-x_train))
    sum_b = np.sum((y_train-y_hat)*(-1))
    det_w = 2 *sum_w
    det_b = 2 *sum_b
    w = w - lr * det_w
    b = b - lr * det_b
print(w)
print(b)

# 可视化
fig,ax = plt.subplots()
ax.scatter(x_train,y_train)
ax.scatter(x_test,y_test,c = 'r')
ax.plot([i for i in range(0,12)],[w[0,0]*i+b for i in range(0,12)])
ax.set_xlabel('YearsExperience')
ax.set_ylabel('Salary')
plt.title('y = w*x + b')
plt.legend(('Training set','Test set'),loc = 'upper left')
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
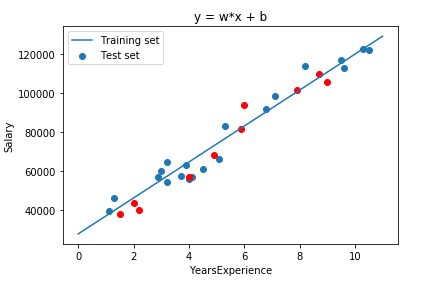
结果及性能分析,导入数据并可视化

参考资料:阿里云开发者社区 - Anaconda配置 (opens new window)
# 基于 CNN 的数字识别训练与验证
实验目的及要求
- 会根据任务设计合适的神经网络
- 熟悉超参数调整的一般规则
实验要求:熟悉常见的神经网络设计,从MLP、CNN、RNN中选择一种模型加以实现,掌握基本的超参数调整原则和方法
number_recognition.py
import torch
import torchvision
from torch.utils.data import DataLoader
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
import matplotlib.pyplot as plt

n_epochs = 3
batch_size_train = 64
batch_size_test = 1000
learning_rate = 0.01
momentum = 0.5
log_interval = 10
random_seed = 1
torch.manual_seed(random_seed)

train_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=True, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_train, shuffle=True)
test_loader = torch.utils.data.DataLoader(
    torchvision.datasets.MNIST('./data/', train=False, download=True,
                               transform=torchvision.transforms.Compose([
                                   torchvision.transforms.ToTensor(),
                                   torchvision.transforms.Normalize(
                                       (0.1307,), (0.3081,))
                               ])),
    batch_size=batch_size_test, shuffle=True)

examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)
# print(example_targets)
# print(example_data.shape)

fig = plt.figure()
for i in range(6):
    plt.subplot(2, 3, i + 1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Ground Truth: {}".format(example_targets[i]))
    plt.xticks([])
    plt.yticks([])
plt.show()


class Net(nn.Module):
    def __init__(self):
        super(Net, self).__init__()
        self.conv1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv2 = nn.Conv2d(10, 20, kernel_size=5)
        self.conv2_drop = nn.Dropout2d()
        self.fc1 = nn.Linear(320, 50)
        self.fc2 = nn.Linear(50, 10)

    def forward(self, x):
        x = F.relu(F.max_pool2d(self.conv1(x), 2))
        x = F.relu(F.max_pool2d(self.conv2_drop(self.conv2(x)), 2))
        x = x.view(-1, 320)
        x = F.relu(self.fc1(x))
        x = F.dropout(x, training=self.training)
        x = self.fc2(x)
        return F.log_softmax(x, dim=1)

network = Net()
optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

train_losses = []
train_counter = []
test_losses = []
test_counter = [i * len(train_loader.dataset) for i in range(n_epochs + 1)]


def train(epoch):
    network.train()
    for batch_idx, (data, target) in enumerate(train_loader):
        optimizer.zero_grad()
        output = network(data)
        loss = F.nll_loss(output, target)
        loss.backward()
        optimizer.step()
        if batch_idx % log_interval == 0:
            print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(epoch, batch_idx * len(data),
                                                                           len(train_loader.dataset),
                                                                           100. * batch_idx / len(train_loader),
                                                                           loss.item()))
            train_losses.append(loss.item())
            train_counter.append((batch_idx * 64) + ((epoch - 1) * len(train_loader.dataset)))
            torch.save(network.state_dict(), './model.pth')
            torch.save(optimizer.state_dict(), './optimizer.pth')

def test():
    network.eval()
    test_loss = 0
    correct = 0
    with torch.no_grad():
        for data, target in test_loader:
            output = network(data)
            test_loss += F.nll_loss(output, target, reduction='sum').item()
            pred = output.data.max(1, keepdim=True)[1]
            correct += pred.eq(target.data.view_as(pred)).sum()
    test_loss /= len(test_loader.dataset)
    test_losses.append(test_loss)
    print('\nTest set: Avg. loss: {:.4f}, Accuracy: {}/{} ({:.0f}%)\n'.format(
        test_loss, correct, len(test_loader.dataset),
        100. * correct / len(test_loader.dataset)))


train(1)

for epoch in range(1, n_epochs + 1):
    train(epoch)
    test()


fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')


examples = enumerate(test_loader)
batch_idx, (example_data, example_targets) = next(examples)
with torch.no_grad():
    output = network(example_data)
fig = plt.figure()
for i in range(6):
    plt.subplot(2, 3, i + 1)
    plt.tight_layout()
    plt.imshow(example_data[i][0], cmap='gray', interpolation='none')
    plt.title("Prediction: {}".format(output.data.max(1, keepdim=True)[1][i].item()))
    plt.xticks([])
    plt.yticks([])
plt.show()


continued_network = Net()
continued_optimizer = optim.SGD(network.parameters(), lr=learning_rate, momentum=momentum)

network_state_dict = torch.load('model.pth')
continued_network.load_state_dict(network_state_dict)
optimizer_state_dict = torch.load('optimizer.pth')
continued_optimizer.load_state_dict(optimizer_state_dict)

for i in range(4, 9):
    test_counter.append(i*len(train_loader.dataset))
    train(i)
    test()

fig = plt.figure()
plt.plot(train_counter, train_losses, color='blue')
plt.scatter(test_counter, test_losses, color='red')
plt.legend(['Train Loss', 'Test Loss'], loc='upper right')
plt.xlabel('number of training examples seen')
plt.ylabel('negative log likelihood loss')
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
结果及性能分析:图片数据可视化

数据分配
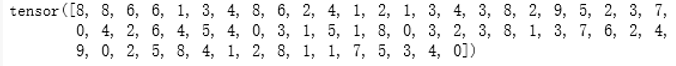
模型验证

在 PyTorch 中创建一个简单的 CNN 神经网络,并使用 MNIST 数据集训练它识别手写数字
MNIST 是计算机视觉领域中最为基础的一个数据集,其中包含 70000 张手写数字图像,其中 60000 张用于训练,10000 张用于测试
参考资料:CSDN - Pytorch入门 - MNIST数字识别 (opens new window)
# 基于 VAE 的数字生成训练与验证
实验目的和要求
- 会根据任务设计合适的神经网络
- 熟悉超参数调整的一般原则
- 通过编写代码,进一步理解和掌握变分自编码器(VAE)
实验要求
- 利用 MNIST 数据集,训练 VAE 生成手写体数字
- 结合代码学习相关的 VAE 模块
- 可视化
- 随机选择 20 个数字作为 VAE 的输入,分别输出在第 5 轮、10 轮、20 轮,以及训练结束后的轮次生成的输出图像
- 将最后一轮得到的每个输入数字的隐状态映射为一个点,通过不同颜色加以区分,并用散点图输出
- 实验结果及分析
vae_number_recognition.py
# prerequisites
import torch
import torch.nn as nn
import torch.nn.functional as F
import torch.optim as optim
from torchvision import datasets, transforms
from torch.autograd import Variable
from torchvision.utils import save_image

bs = 100
# MNIST Dataset
train_dataset = datasets.MNIST(root='./mnist_data/', train=True, transform=transforms.ToTensor(), download=True)
test_dataset = datasets.MNIST(root='./mnist_data/', train=False, transform=transforms.ToTensor(), download=False)

# Data Loader (Input Pipeline)
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=bs, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=bs, shuffle=False)


class VAE(nn.Module):
    def __init__(self, x_dim, h_dim1, h_dim2, z_dim):
        super(VAE, self).__init__()

        # encoder part
        self.fc1 = nn.Linear(x_dim, h_dim1)
        self.fc2 = nn.Linear(h_dim1, h_dim2)
        self.fc31 = nn.Linear(h_dim2, z_dim)
        self.fc32 = nn.Linear(h_dim2, z_dim)
        # decoder part
        self.fc4 = nn.Linear(z_dim, h_dim2)
        self.fc5 = nn.Linear(h_dim2, h_dim1)
        self.fc6 = nn.Linear(h_dim1, x_dim)

    def encoder(self, x):
        h = F.relu(self.fc1(x))
        h = F.relu(self.fc2(h))
        return self.fc31(h), self.fc32(h)  # mu, log_var

    def sampling(self, mu, log_var):
        std = torch.exp(0.5 * log_var)
        eps = torch.randn_like(std)
        return eps.mul(std).add_(mu)  # return z sample

    def decoder(self, z):
        h = F.relu(self.fc4(z))
        h = F.relu(self.fc5(h))
        return F.sigmoid(self.fc6(h))

    def forward(self, x):
        mu, log_var = self.encoder(x.view(-1, 784))
        z = self.sampling(mu, log_var)
        return self.decoder(z), mu, log_var


# build model
vae = VAE(x_dim=784, h_dim1=512, h_dim2=256, z_dim=2)
if torch.cuda.is_available():
    vae.cuda()

print(vae)

optimizer = optim.Adam(vae.parameters())
# return reconstruction error + KL divergence losses
def loss_function(recon_x, x, mu, log_var):
    BCE = F.binary_cross_entropy(recon_x, x.view(-1, 784), reduction='sum')
    KLD = -0.5 * torch.sum(1 + log_var - mu.pow(2) - log_var.exp())
    return BCE + KLD


def train(epoch):
    vae.train()
    train_loss = 0
    for batch_idx, (data, _) in enumerate(train_loader):
        # 取消cuda
        # data = data.cuda()
        data = data.cpu()
        optimizer.zero_grad()

        recon_batch, mu, log_var = vae(data)
        loss = loss_function(recon_batch, data, mu, log_var)

        loss.backward()
        train_loss += loss.item()
        optimizer.step()

        if batch_idx % 100 == 0:
            print('Train Epoch: {} [{}/{} ({:.0f}%)]\tLoss: {:.6f}'.format(
                epoch, batch_idx * len(data), len(train_loader.dataset),
                       100. * batch_idx / len(train_loader), loss.item() / len(data)))
    print('====> Epoch: {} Average loss: {:.4f}'.format(epoch, train_loss / len(train_loader.dataset)))


def test():
    vae.eval()
    test_loss = 0
    with torch.no_grad():
        for data, _ in test_loader:
            # 取消cuda
            # data = data.cuda()
            data = data.cpu()
            recon, mu, log_var = vae(data)

            # sum up batch loss
            test_loss += loss_function(recon, data, mu, log_var).item()

    test_loss /= len(test_loader.dataset)
    print('====> Test set loss: {:.4f}'.format(test_loss))

for epoch in range(1, 51):
    train(epoch)
    test()

with torch.no_grad():
    # cuda改为cpu
    z = torch.randn(64, 2).cuda()
    sample = vae.decoder(z).cuda()

    save_image(sample.view(64, 1, 28, 28), './samples/sample_' + '.png')
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
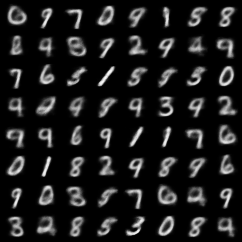
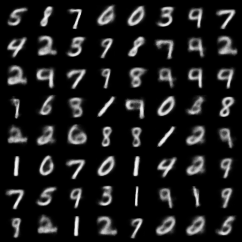
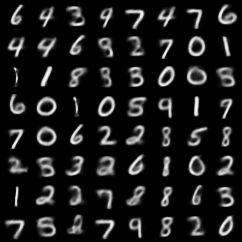
结果及性能分析
五轮训练结果
十轮训练结果
二十轮训练结果
参考资料
# 大模型概述
大概理解为
- 神经网络 CNN = 万能函数拟合器
- 卷积 = 滤波和特征提取
- 全连接层 = 加权求和
- 反向传播 = 自后向前调整权重参数
- 模型设计 = 搭积木
# Transformer
英伟达慈父
深度学习历程
- 2012:AlexNet 依据 CUDA GPU 算力 + CNN 卷积神经网络 + 大数据标注图片实现多层的神经网络训练
- 2013~2014:疯狂堆深度,GoogleNet 在几十层曲线非常美妙,但深度达到三位数,力大飞砖没效果了,回归曲线开始下滑
- 一开始认为是发生了梯度消失 / 爆炸,但 Batch Normalization(2015) 基本缓解了这个问题,仍会出现退化
- 根本原因是深层训练优化极其困难,难以建立起有效的恒等映射
- 2015:何凯明提出 ResNet,通过残差连接解决退化问题,通过 shortcut 跳跃连接使用恒等映射保底,使得模型层数进入 3、4 位数
- 2016~2017:一直在玩残差网络,将 CNN(Convolutional Neural Networks)逐步完善
- 2017:提出 Transformer,完全不用卷积 / 循环,只用自注意力机制训练神经网络,最开始用在 NLP(解决长距离依赖),后来才用在 CV 做图像处理,再后来用在语言模型
CNN 和 Transformer 都是在做提取图像特征、建模像素 / 区域之间的关联,其区别在于
- CNN:用卷积核 + 局部滑动做特征
- Transformer:用自注意力 Self-Attention 做特征
Transformer 架构

代码复现:Transformer 模型编码器
- 输入嵌入层
- 位置编码
- 多头自注意力层
- 层归一化
- 前馈神经网络
参考
- Coding a Transformer from scratch on PyTorch, with full explanation, training and inference-YouTube (opens new window)
- A PyTorch implementation of the Transformer model in "Attention is All You Need" (opens new window)
输入嵌入层:获取句子输入处理为 512 维的向量,即 d_model
'''输入器'''
class InputEmbeddings(nn.Module):

    def __init__(self, d_model: int, vocab_size: int):
        super().__init__()
        self.d_model = d_model
        self.vocab_size = vocab_size
        self.embedding = nn.embedding(vocab_size, d_model)


    def forward(self, x):
        return self.embedding(x) * math.sqrt(self.d_model)
2
3
4
5
6
7
8
9
10
11
12
通过 torch.nn 直接构建从句子长度(vocab_size)到所需向量(d_model)的嵌入层,同时,论文中把 √d_model 作为该层的权重与之相乘
位置编码:对输入嵌入生成的向量进行位置编码
'''创建矩阵'''
pe = torch.zeros(seq_len, d_model)

'''如何构建向量'''
position = torch.arange(0, seq_len, dtype = torch.float).unsqueeze(1)
div_term = torch.exp(torch.arange(0, d_model, 2).float) * (-math.log(10000.0) / d_model)

'''sin 函数对偶数处理'''
pe[:, 0::2] = torch.sin(position * div_term)
'''cos 函数对奇数处理'''
pe[:, 1::2] = torch.cos(position * div_term)
pe = pe.unsqueeze(0)
2
3
4
5
6
7
8
9
10
11
12
transformer 模型通过位置编码来捕获输入序列中的位置信息,使模型能够理解词语在序列中的位置关系
层归一化处理
加一个 ε 是为了防止 σ 过于贴近 0
class LayerNormalization(nn.Module):

    def __init__(self, eps: float = 10**-6) -> None:
        super().__init__()
        self.eps = eps
        self.alpha = nn.Parameter(torch.ones(1))
        self.bias == nn.Parameter(torch.zeros(1))

    def forward(self, x):
        mean = x.mean(dim = -1, keepdim = True)
        std = x.std(dim = -1, keepdim = True)
        return self.alpha * (x-mean) / (std + self.eps)
2
3
4
5
6
7
8
9
10
11
12
层归一化对每个神经层的输入数据进行归一化处理,使其分布更加稳定和一致,以提高神经网络的尺度不变性,避免梯度消失
前馈网络(Position-wise Feed-Forward Networks)
输入的d(model) = 512并且d(ff) = 2048,即向量长度要从 512 构建到 2048
class FeedFordwardBlock(nn.Module):
    def __init__(self, d_model: int, d_ff: int, dropout: float) -> None
        super().__init__()
        self.linear_1 = nn.Linear(d_model, d_ff) # w1 和 b1
        self.dropout = nn.Dropout(dropout)
        self.linear_2 = nn.Linear(d_ff, d_model) # w2 和 b2

    def forward(self, x):
        # 张量的转换:d_model -> d_ff -> d_model
        return self.linear_2(self.dropout(torch.relu(self.linear_1(x))))
2
3
4
5
6
7
8
9
10
同样利用 torch.nn 直接构建该神经网络的线性层
多头自注意力层:最重要的模块,得到编码器的输入并使用它三次,分别为查询、键和值,对应之前提到的注意力公式中的三个重要参数(相当于相同的输入,应用了三次)
注意力公式
代码实现
class MultiHeadAttentionBlock(nn.Module):
    def __init__(self, d_model: int, h: int, dropout: float) -> None:
        super().init()
        self.d_model = d_model
        self.h = h
        assert d_model % h == 0, "d_model is not divisible by h"
        self.d_k = d_model // h
        self.w_q = nn.Linear(d_model, d_model) # Wq 查询
        self.w_k = nn.Linear(d_model, d_model) # Wk 键
        self.w_v = nn.Linear(d_model, d_model) # Wv 值
        self.w_o = nn.Linear(d_model, d_model) # Wo 注意力输出
        self.dropout = nn.Dropout(dropout)

        # 计算我们想要的注意力分数
        @staticmethod
        def attention(query, key, value, mask, dropout: nn.Dropout):
            d_k = query.shape[-1]
            attention_scores = (query @ key.transpose(-2, -1)) / math.sqrt(d_k)
            if mask is not None:
                attention_scores.masked_fill_(mask == 0, -1e9)
                attention_scores = attention_scores.softmax(dim = -1)
                if dropout is not None:
                    attention_scores = dropout(attention_scores)
                    return (attention_scores @ value), attention_scores

                def forward(self, q, k, v, mask): # 矩阵处理,令三个查询的矩阵和 d_k 相关
                    query = self.w_q(q)
                    key = self.w_k(k)
                    value = self.w_v(v)
                    query = query.view(query.shape[0], query.shape[1], self.h, self.d_k).transpose(1, 2)
                    key = key.view(key.shape[0], key.shape[1], self.h, self.d_k).transpose(1, 2)
                    value = value.view(value.shape[0], value.shape[1], self.h, self.d_k).transpose(1, 2)
                    x, self.attention_scores = MultiHeadAttentionBlock.attention(query, key, value, mask, self.dropout)
                    # (batch, h, Seq_Len, d_k) --> (batch, Seq_Len, h, d_k) --> (batch, Seq_Len, d_model)
                    x = x.transpose(1, 2).contiguous().view(x.shape[0], -1, self.h * self.d_k)
                    return self.w_o(x)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
# 模型指纹
本质是词语接龙的概率模型
无法通过直接问模型 "你是什么模型" 得到答案
- 训练数据:"是什么模型" 这一事实并不决定模型的输出,这取决于训练过程中语料比重,最终的输出也只是一个概率事件
- 提示词:在 RLHF 过程,很多厂商会加入"你叫什么"、"你是谁开发的"这类问答,导致最后模型的输出和原始的训练概率也不相同
通过模型指纹识别一个模型
Tokenizer 词表:BPE 分词器的词表由训练语料统计生成,同一型号的模型共享几乎相同的词表,给模型一段特定文本,看它能切出多少 Token 以及切分的方式,基本可以锁定
BPE(Byte Pair Encoding,字节对编码)是目前最主流的大语言模型分词算法之一
logprob(Logarithmic Probability 对数概率):给定同样的 prompt,不同模型输出的 token 概率分布差异很大。采集几百条 prompt 的 top-5 logprob 统计对比,可以缩小范围
特殊 Token:不同模型的控制 Token,例如思考过程中的
<think>, <|im_start|>, <|endoftext|>不相同知识截止:问模型最近发生的事件,结合公开的训练节点推断
风格:比较玄学了,例如 GPT 喜欢列任务,Deepseek 废话少
设计一个有效的 Tokenizer 探针,文本集覆盖容易产生差异的输入:多语言混合、生僻 Unicode、代码片段、长数字串、特定中文组合
- 最常见的方式:冷知识探针
构造文本集:构造探针文本
	↓
采集指纹:调用 Tokenizer 切分文本
	↓
建指纹库:将文本递给已知模型切分
	↓
比对:将未知模型的切分和指纹库比对
2
3
4
5
6
7
# 训练过程
现在的大模型训练已经不是一个非常技术化的活,愈加偏向于工程化;微调、蒸馏及量化,都属于后训练,GLM5.3 和 DeepSeek 4 Flash 都是在前代基础上后训练的成果
- 预训练(在海量语料上自监督学习) → Base Model,该阶段的模型只会"续写"文本,但不会"回答问题",不知道正确与否
- 持续预训练(喂垂直领域语料) → 领域基座
- 监督微调 / 指令微调(SFT) → SFT Model
- RLHF 对齐(训练 RM → PPO/DPO 优化) → 对齐模型
- 下游任务微调 / PEFT(接入具体业务数据/使用 LoRA) → 业务模型
- 蒸馏 + 量化(追求推理速度和体积) → 部署模型
模型微调:SFT( Supervised Fine-Tuning)监督微调,SFT 用海量的“问题-答案”对(Prompt-Response)喂给主模型,告知其怎么回答是对的,通常所说的微调(Fine-Tuning)指的就是这一阶段工作
RLHF(Reinforcement Learning from Human Feedback)通过人类反馈的强化学习,RLHF 的三个阶段即 SFT - RM - PPO
- RM(Reward Model)奖励模型,专门训练一个小模型,专门对主模型的回答进行量化评分
- PPO(Proximal Policy Optimization)近端策略优化,主模型每生成一句话,RM 就打个分,而 PPO 负责把主模型的参数往“高分方向”微调
当前工业界正在向 DPO / RFT 等简化方案迁移:大致思路是把 RM 和 PPO 合并,把“打分”的逻辑写进损失函数里,在后训练时一步对齐
联邦学习 = 归并式的机器学习,子模型在各自机器上训练开发,主模型通过提交的 PR 进行增量更新