
 线性结构
# C++ 基础
刷题常用语法、STL 容器与工具库速查,只记常用接口
# C/C++ 语法
引包和命名域
#include <stdio>
using namespace std;
2
输入输出:格式符与变量一一对应,浮点用 %.nf 控制小数位数
int i; float f; char c;
scanf("%d %f %c", &i, &f, &c);
printf("i = %d, f = %.4f, c = %c", i, f, c);
2
3
- 浮点数除以整数仍为浮点数:
f/4 - 浮点转整型直接强转,小数部分截断:
int i = (int) f;
链式条件判断从左往右逐次求值,与数学直觉不同
int a = 1, b = 2, c = 3;
if(a > b > c)                    printf("1");
else if((a+1) >= b == (c-2))     printf("2");
else                             printf("3");
2
3
4
a>b>c:先算a>b得false == 0,再判断0 > c,为假a+1 >= b == c-2:先算a+1 >= b得true == 1,再判断1 == c-1
# STL 接口
数组和指针繁琐,能上 STL 就上 STL;不定行列数的矩阵可用模板的非类型形参处理,Effective C++ 里有介绍和优化
# 数据结构
map:m[i] = j 插入键值对,count(i) 判断键是否存在(结果只有 1/0),auto 遍历
map<int, int> _map;
_map[9] = 10;

if(_map.count(9)){
    cout << "9 exist, the value is" << _map[9] << endl;
}

for(auto it: _map){
    cout << it.first << " : " << it.second << endl;
}
for(auto it = _map.begin(); it != _map.end(); it++){
    cout << it->second;
}
2
3
4
5
6
7
8
9
10
11
12
13
键为指针时必须重载 operator(),明确如何判定指针的“相同”
struct ListNode {
    int val;
    ListNode *next;
    ListNode(int x) : val(x), next(NULL) {}
};

class Solution {
public:
    bool operator()(const ListNode* s1, const ListNode* s2 ) const{
        return s1->val != s2->val;
    }

    ListNode *detectCycle(ListNode *head) {
        map<ListNode*, int> m;
        int index = 0;
        while(head){
            if(m.count(head)){
                return head;
            }
            m[head] = index++;
            head = head->next;
        }
        return NULL;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
set:insert() 插入,count() 判断是否存在
set <int> _set;
_set.insert(7);

if(_set.count(4)){
    cout << "dead" << endl;
}
2
3
4
5
6
vector:push_back() 尾插,erase() 按下标删,back() 取末尾元素
vector<int> vec;
vec.push_back(1);
vec.push_back(4);

// 删除下标为 1 的元素
vec.erase(vec.begin()+1);
2
3
4
5
6
合并区间:sort() 对 vector<vector<int>> 排序时比较的是每个元素的首位,即 vec[0]
class Solution {
public:
    vector<vector<int>> merge(vector<vector<int>>& intervals) {
        vector<vector<int>> res;
        sort(intervals.begin(), intervals.end());
        for(int i = 0; i < intervals.size(); i++){
            vector<int> cur = intervals[i];
            if(res.empty() || cur[0] > res.back()[1]){
                res.push_back(cur);
            }
            if(cur[1] > res.back()[1]){
                res.back()[1] = cur[1];
            }
        }
        return res;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
初始化、拷贝与清理
vector<int> vec(n);             // 长度 n,值全为 0
vector<int> vec(n, 1);          // 长度 n,值全为 1
vector<vector<int>> matrix(n, vector<int> (n));

vector<int> first(pre);                        // 创建时拷贝
vector<int> second;
second.assign(pre.begin(), pre.end());         // 创建后复制
vector<int> third;
third.swap(pre);                               // 复制并清空原数组 pre
vector<int> four;
four.insert(four.begin(), pre.begin(), pre.end());  // 在指定位置插入一段

vec.clear();                  // 清空但不回收内存
vector<int>().swap(vec);      // 清空且回收内存
2
3
4
5
6
7
8
9
10
11
12
13
14
stack:top() 取栈顶(空栈时未定义)、push() 压栈、pop() 弹栈(无返回)、size()、empty()
deque:处理首部元素时效率远高于 vector —— push_front/push_back、pop_front/pop_back、front/back
pair:配合 map 或 vector 使用
pair<int,int> p (1,1);
pair p = make_pair('h', 9);

vector<pair<int,int>> map;              // vector + pair 实现 map
map.insert(pair<int,int>(1,2));
map.insert(make_pair(1,2));
2
3
4
5
6
priority_queue:把 lambda 表达式作为模板参数传入构造函数,这里是按数组第三位元素从小到大排序
auto cmp = [](const vector<int>& a, const vector<int>& b){
    return a[2] > b[2];
};
priority_queue<vector<int>, vector<vector<int>>, decltype(cmp)> queue(cmp);
queue.push({0,0,0});
queue.emplace({1,1,1});
queue.top();
queue.pop();
2
3
4
5
6
7
8
# vector 和数组
用 vector<int> 标记代替 bool 数组,直接写 bool row[m], col[n] 在寻址时会报未初始化的错;C 中 bool 本就用 int 实现,二者可以相互赋值
// 将二维矩阵中为 0 的元素所在行、列均置零
class Solution {
public:
    void setZeroes(vector<vector<int>>& matrix) {
        int m = matrix.size();
        int n = matrix[0].size();
        vector<int> row(m), col(n);
        for(int i = 0; i < m; i++){
            for(int j = 0; j < n; j++){
                if(matrix[i][j] == 0){
                    row[i] = true;
                    col[j] = true;
                }
            }
        }
        for(int i = 0; i < m; i++){
            for(int j = 0; j < n; j++){
                if(row[i] || col[j]){
                    matrix[i][j] = 0;
                }
            }
        }
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
范围已知时用数组也行,注意初始化语句的写法
// 判断九宫格数独是否有解
class Solution {
public:
    bool isValidSudoku(vector<vector<char>>& board) {
        // 数组定义和初始化
        int row[9][9] = {{0}}, col[9][9] = {{0}};
        int block[3][3][9] = {{{0}}};
        for(int i = 0; i < 9; i++){
            for(int j = 0; j < 9; j++){
                char c = board[i][j];
                int k = c-'1';
                if(c != '.'){
                    if(row[i][k] || col[k][j] || block[i/3][j/3][k]){
                        return false;
                    }
                    row[i][k] = true;
                    col[k][j] = true;
                    block[i/3][j/3][k] = true;
                }
            }
        }
        return true;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# 位运算
只出现一次的数字用异或:0 ^ a = a,a ^ a = a,a ^ a ^ b = b
class Solution {
public:
    int singleNumber(vector<int>& nums) {
        int res = 0;
        for(int i = 0; i < nums.size(); i++){
            res ^= nums[i];
        }
        return res;
    }
};
2
3
4
5
6
7
8
9
10
# 工具库和 λ 表达式
# algorithm
| 接口 | 说明 |
|---|---|
max()/min() | 最大值、最小值 |
sort(b, e) | 排序一段连续地址,数组写作 sort(arr, arr+10) |
sort(b, e, cmp) | 自定义规则,可传函数或 lambda |
max_element(b, e) | 返回最大值迭代器,需 * 取值 |
reverse(b, e) | 翻转 |
find(b, e, v) | 返回迭代器,减去 begin() 即下标 |
res = max(prices[i]-pre, res);

sort(vec.begin(), vec.end());   // vec 为 vector
sort(arr, arr+10);              // arr 为数组

// 结构体排序:成绩升序,成绩相同按名字
bool cmp(Student lhs, Student rhs){
    return lhs.grade < rhs.grade
           || (lhs.grade == rhs.grade && lhs.name < rhs.name);
}
sort(begin(vec), end(vec), cmp);

// lambda 作第三个参数:按第二个元素从小到大
sort(intervals.begin(), intervals.end(), [](const auto& u, const auto& v){
    return u[1]<v[1];
});

// 字符串原地按字典序排序,返回值为空
string str = "dcba";
sort(str.begin(), str.end());   // str == "abcd"

// 最大值、下标、翻转
int max = *max_element(vec);
cout << find(nums.begin(), nums.end(), 3) - nums.begin();  // 值 3 的下标
reverse(str);
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
# string
string str(n, ' ');                        // 长度为 n,用空格填充
string s1 = "hahaha ", s2 = "nmsl";
string s3 = s1 + s2;                       // 拼接,s3 == "hahaha nmsl"

char c = i + '0';              // 整型转字符
int j = c - '0';               // 字符转整型

string str = to_string(55);    // 数字(整型/浮点)转字符串
string cur = s.substr(i, 10);  // 起始下标 + 截取长度

for(int i = 0; i < str.size(); i++){   // 也可以用 length()
    cout << str[i] << endl;
}
2
3
4
5
6
7
8
9
10
11
12
13
erase() 删除元素:传起始下标 + 删除长度,或传迭代器删单个;删除后其后元素下标均 -1,操作时注意不要 i++
class Solution {
public:
    string minRemoveToMakeValid(string s) {
        stack<char> stc;
        stack<int> sti;
        for(int i = 0; i < s.length();){
            if(s[i] == '('){
                stc.push(s[i]);
                sti.push(i);
                i++;
            } else if(s[i] == ')'){
                if(stc.empty()){
                    s.erase(i, 1);
                } else {
                    stc.pop();
                    sti.pop();
                    i++;
                }
            } else {
                i++;
            }
        }
        while(!sti.empty()){
            s.erase(s.begin()+sti.top());
            sti.pop();
        }
        return s;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
按特定字符分割字符串
list<string> strs;

void split(string data, char c) {
    string str;
    for(auto& ch: data){
        if(ch == c){
            strs.push_back(str);
            str.clear();
        } else {
            str.push_back(ch);
        }
    }
    if(!str.empty()){
        strs.push_back(str);
        str.clear();
    }
    return build();
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# cstdlib
rand() 返回 [0, RAND_MAX] 的随机数(RAND_MAX 定义在 stdlib.h,值为 2147483647),用 rand() % n 产生 (0, n] 的随机数;没有随机种子时每次运行序列相同,故需 srand(time(0))
srand(time(0));
for (int i = 0; i < 10; i++){
    cout << rand()%100 << " ";
}
// 83 86 77 15 93 35 86 92 49 21
2
3
4
5
# λ 表达式
以 [] 作匿名函数的开头,接 () 传参、{} 写函数体与返回值,与 Java 的 lambda 类似,常用于 sort 的第三个参数
451. 根据字符出现频率排序 (opens new window):hash 统计字符数量,再把 pair<char,int> 按值从大到小排序
class Solution {
public:
    string frequencySort(string s) {
        map<char, int> m;
        for(int i = 0; i < s.size(); i++){
            m[s[i]]++;
        }
        vector<pair<char,int>> v;
        for(auto& it: m){
            v.push_back(pair<char, int> (it.first, it.second));
        }

        // lambda 函数作为参数传入
        sort(v.begin(), v.end(), [](pair<char,int> p1, pair<char,int> p2){
            return p1.second > p2.second;
        });

        string res = "";
        for(int i = 0; i < v.size(); i++){
            for(int j = 0; j < v[i].second; j++){
                res += v[i].first;
            }
        }
        return res;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
973. 最接近原点的 K 个点 (opens new window):按点到原点的距离排序后取前 k 个
class Solution {
public:
    vector<vector<int>> kClosest(vector<vector<int>>& points, int k) {
        sort(points.begin(), points.end(), [](vector<int> u, vector<int> v){
            return u[0]*u[0]+u[1]*u[1] < v[0]*v[0]+v[1]*v[1];
        });
        vector<vector<int>> res;
        for(int i = 0; i < k; i++){
            res.push_back(points[i]);
        }
        return res;
    }
};
2
3
4
5
6
7
8
9
10
11
12
13
# 数据结构绪论
# 数据结构基本概念
| 数据有关名称 | |
|---|---|
| 数据 | 字节流 |
| 数据项 | int(基本数据类型) |
| 数据元素 | struct(复合数据类型) |
| 数据对象 | class(包含函数) |
| 数据类型 | |
|---|---|
| 原子数据类型 | int,对应数据项 |
| 结构类型 | struct,对应数据元素 |
| 抽象数据类型 | class,对应数据对象 |
数据结构三要素:注意区分逻辑和物理结构
- 逻辑结构:线性和非线性
- 物理结构:顺序、链式、索引、哈希
- 数据运算:针对逻辑结构而言
一个完整的数据结构必须包括以上三要素,否则不能称作一个严格的数据结构
# 算法和算法评价
算法特性(五个):有穷性;输入输出;确定性;可行性
评价算法质量
- 时间复杂度:基本运算的频度(语句的频度指其被执行的次数,基本运算指算法中嵌套最深的语句)
- 空间复杂度:额外辅助空间大小,如
int[n]大小为O(n),常量为O(1),int[n][n]为O(n^2)
一个算法的时间复杂度一般是指算法平均执行情况的时间复杂度,但有时也指最差的时间复杂度,不同情况注意区分
在求算法的时间复杂度时,对于一般非递归算法,采用求和或积分的方法可以得到基本运算的频度,取其最高次幂作为时间复杂度,如
对于递归算法,需要将每次递归的附加运算f(n)加上
通常这个f(n)是一个常数
# 线性表
线性表:逻辑结构,指线性排列的数据集合,是一种随机存取的存储结构(存取方式指读取方式,线性表可以自由读取)
线性表的两种物理实现:顺序表,链表
- 为什么说是物理实现,因为顺序表的顺序,指的是物理内存的连续,注意和线性这一概念的区别
# 顺序表相关算法
第八题,第十四题
插入位置,若 i 指的是下标,则范围为(0,n),若指的是第几个位置,则为(1,n+1)

关于顺序表的算法:无非CRUD,即create, read, update, delete,多写多做

第六题
- 对于有序顺序表,采用双指针的形式,慢指针指向排好的元素末尾,快指针向后遍历将独一无二的元素添加到慢指针后
- 对于无序表,采用 Map 存储单独元素,构建新的顺序表
第七题:经典的对顺序表剩余的元素进行while(i < n){ res.push_back(L1[i++]); }操作

有点问题,重复看

二分搜索,在数组中插入元素

Hash 表存放每个位置的元素,遍历两次数组,第一次记录map[n+i-p] = L[i],第二次构建数组arr[i] = map[i],空间时间均为O(n)

和那个升序排列构建新数组的题有点像,这里要注意推出时机,使得下一个遍历到的元素为两个表公共中位数,时间O(n)空间O(1)

Hash 表处理,时空均为O(n)

好难
# 链表定义及算法
关于单链表的基本算法:
- 头插、尾插:头节点尾节点方便运算
- 前插、后插
- 删除:先删链(注意顺序不要断链),再 free 结点
双链表:方便前后邻接数据处理,可以很简单地找到前驱节点
循环链表 - 双向循环链表:判空看头指针H->next是否为头指针H(一般循环链表设尾指针不设头指针)
静态链表:数组实现的链表,每个数组元素链向数组的下一个下标,这样在删除添加数据时只用移动一个位置元素


应选 C,因为要遍历到 m 链表的尾节点

这种选择合适数据结构的题,其实就是看操作方不方便,方便指时间复杂度低,尽量往 O(1) 上靠,这里只有带头节点的双循环链表能够实现 O(1),带尾指针的单循环链表要 O(n) 才能实现删除末尾节点

同理 C 能够使两个操作均为 O(1),所以选 C

画图,循环链表判空条件h->next = h

void deleteX(LNode *n, int x){
    if(n == NULL){
        return;
    } else if(n->val == x){
        LNode *p = h;
        h = h->next;
        free(p);
        deleteX(h, x);
    } else {
        deleteX(h->next, x);
    }
}
2
3
4
5
6
7
8
9
10
11
12
为什么不会断链?

我想用递归算法求解,时间复杂度 O(n),未经验证,可能是对的
int flag = 0;
int deep(LNode* n, int k){
    if(n->next == NULL){
        return 1;
    }
    int cur = 1+deep(n->next, k);
    if(cur == deep){
        cout << n->val;
        flag = 1;
    }
    return deep
}

int getK(LNode* h, int k){
    deep(h, k);
    return flag;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
实在不行用最笨的方法遍历两次,第一次读到长度 n,则所求元素正序为 n-k,再遍历一次取值

最笨的办法,用set存储LNode*,先遍历 L1,再遍历 L2,返回遍历 L2 时第一个重复的节点


用 set 判重,快慢指针删除单链表元素

很久以前写过,因为要求空间复杂度为 O(1),不能用额外数据结构,解题步骤如下
- 截取后半段链表
- 反转后半段链表
- 合并前后两段链表
// 截取链表后半段,带头节点
LNode* split(LNode* h){
    int n = 0;
    LNode* p = h;
    while(p != NULL) { p = p->next; n++; }
    p = h;
    for(int i = 0; i < n/2; i++){
        p = p->next;
    }
    // 得到后半段的第一个节点,新增头节点l,返回
    LNode* l;
    l->next = p->next;
    p->next = NULL;
    return l;
}

// 递归反转链表,不带头节点
LNode* reverseNode(LNode* n){
    if(n->next == NULL){
        return n;
    }
    reverseNode(n->next)->next = n;
    return n;
}
// 封装翻转函数,处理尾节点和头节点
LNode* reverseList(LNode* h){
    LNode* tail = h;
    while(tail->next != NULL){ tail = tail->next; }
    reverseNode(h)->next = NULL; // 将原先的头节点,现在尾节点的 next 置空
    return tail; // 返回原先的尾节点,现在的头节点
}

// 合并两个链表l1,l2,其中l1带头节点,l2不带头节点
LNode* merge(LNode* l1, LNode* l2){
    LNode* h = l1, *p = h; // 保存头节点和创建移动节点
    l1 = l1->next; l2 = l2->next;
    int count = 0;
    while(l1 != NULL && l2 != NULL){ // 遍历两个链表
        if(count % 2 == 0){
            p->next = l1;
            l1 = l1->next;
            p = p->next;
        }else {
            p->next = l2;
            l2 = l2->next;
            p = p->next;
        }
        count++;
    }
    // 因为分割链表时取得 n/2,所以只有可能后半段链表比前半段链表多一个元素
    while(l2 != NULL){
        p->next = l2;
        l2 = l2->next;
        p = p->next;
    }
    return h; // 返回合并的链表的头节点
}

void solve(LNode* h){ // 整理出解决算法
    LNode* l = split(h);
    LNode* r = reverseList(l);
    merge(h, r); // 头节点没变,h 仍为头节点
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
不要用递归翻转链表,用头插法翻转(带头节点)
void reverse(LNode* h){
    LNode *pre = h->next, *cur = NULL;
    if(pre != NULL){ cur = h->next; }
    else{ return; } // 空表直接返回
    // 取第一个元素为尾节点,后继置空
    pre->next = NULL;
    while(cur != NULL){
        LNode* next = cur->next; // 保存下一节点
        cur->next = pre; // 令当前节点指向前一节点
        pre = cur; // 保存当前节点,下一轮要指
        cur = next; // 更新当前节点
    }
    // 头节点指向新的第一元素
    h->next = cur;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# 受限线性表
# 栈和队列
顺序栈:注意区分栈顶指针指向空还是实际元素,这决定出入栈指针的改变的执行次序
typedef struct{
    int* data;
    int top;
    int size;
}sequence_stack;
2
3
4
5
共享栈:两个栈共享存储空间,栈底分别为0/-1和n/n+1向中间入栈,可以有效节省存储空间和防止栈上溢
链栈:注意区分是否有头节点,另外牢记指针是向下指的,即从栈顶指向栈底,链栈一般情况下不会溢出
LNode{
    int val;
    LNode* next;
}
2
3
4
弹栈合法序列判断
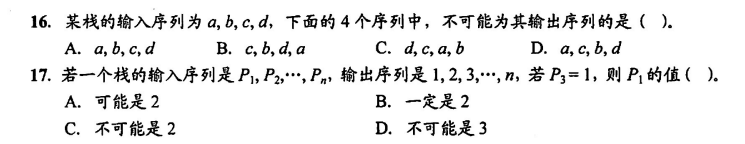
经验:找出第一个弹栈元素,明确该元素之前的元素此刻全在栈中,以此为初始状态模拟并分析栈中情况
有一些不可能出现的情况,如 1 2 3 依次入栈,若 3 第一个弹出,则 1 不可能紧接着 3 弹出(因为此时 2 一定在栈中,分隔开 3 和 1)
十六题显然 C,十七题好难选 C
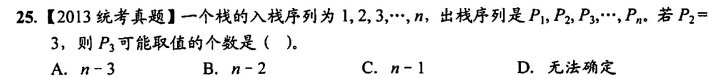
如上述所述情况,此时只有可能取不到 1,其余都有可能,所以可能取值的个数为 n-1,选 C
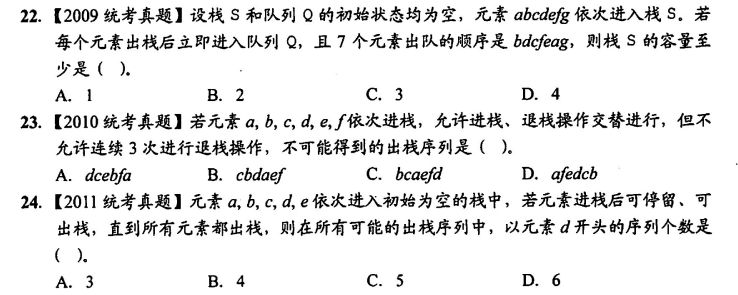
模拟过程,一定要注意一些序列是肯定非法的,是取不到的,22 选 C,23 选 D,24 选 B
设计一个共享栈
int push(int i, int val){
    if(i < 0 || i > 1) { return -1; } // 栈号不对
    if(s.top[1]-s.top[0] == 1){
        return 0; // 栈已满
    }
    // 入栈
    switch(i){
        case 0: s.stack[++s.top[0]] = val; break;
        case 1: s.stack[--s.top[1]] = val;
    }
    return 1;
}

int pop(int i){
    if(i < 0 || i > 1) { exit(0); } // 栈号不对
    // 出栈
    switch(i){
        case 0: {
            if(s.top[0] < 0){
                return -1; // 栈空
            }
            return s.stack[s.top[0]--] = val;
        }
        case 1: {
            if(s.top[1] >= maxsize){
                return -1; // 栈空
            }
            return s.stack[s.top[1]++];
        }
    }
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
设计一个返回当前最小值操作复杂度为 O(1) 的栈:维护一个副栈,用于存当前位置上的主栈的最小值(高度相同)
bool push(int val){
    if(s1.top == maxsize){
        return false;
    }
    // 主栈正常push,top指向栈顶元素
    s1.data[++s1.top] = val;
    // 比较当前最小值和新push的值,更新当前的最小值并存入s2
    int min = min(s2.data[s2.top], val);
    s2.data[++s2.top] = min;
    return true;
}

int getMin(){
    if(s2.top == 0){ // 空栈返回最小值
        return INT_MIN;
    }
    return s2.data[s2.top];
}

bool pop(){
    if(s1.top == 0){
        return false;
    }
    // 弹两个栈
    s1.top--; s2.top--;
    return true;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
相应的,取出最小值的空间复杂度为 O(n),空间换时间
顺序队
typedef struct{
    int* data;
    int front, rear;
    int size;
}
2
3
4
5
链队:链表结构的队列,常有头尾指针以便出入队 O(1)
typedef struct{
    int data;
    LinkNode* next;
}LinkNode;

typedef struct{
    LinkNode *front, *rear;
}LinkQueue;
2
3
4
5
6
7
8
循环队列的判断
- 判空条件:
front == rear - 判满条件:
rear+1 == front
双端队列:两边都可以出入队的队列
受限双端队列
- 一端只进不出,另一端可进可出
- 一端只出不进,另一端可进可出
对于一般队列,其输出和输出一定是保持一致的(FIFO),选 B

单个队列中,严格先进先出,多个队列,可以一定程度上控制队列的输出顺序
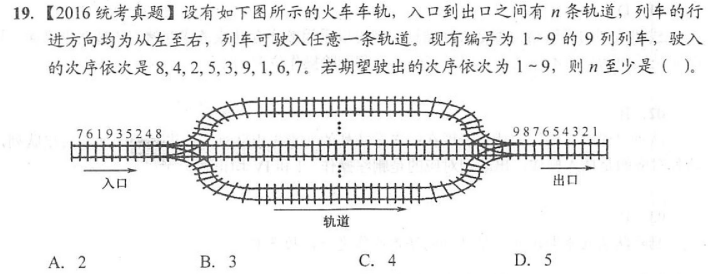
上题[8 9]、[4 5]、[2 3]、[1],共四个队列可以满足顺序输出 1-9,选 C
只有对于受限的双端队列,其输出比较多样,可以出判断是否合法的题目
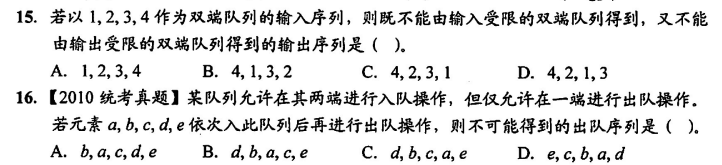
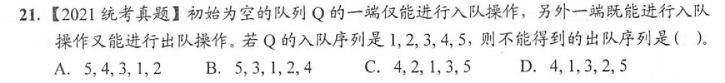
答案依次为 C C D
和栈结合考察
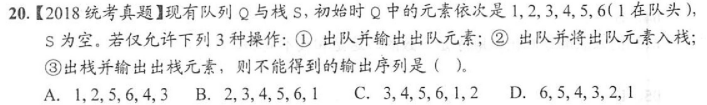
选 C
首位指针的考察
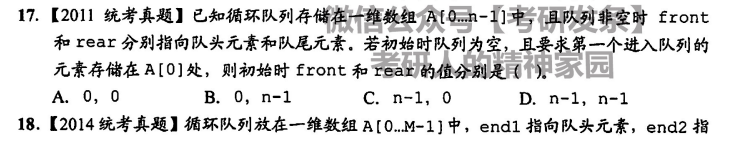
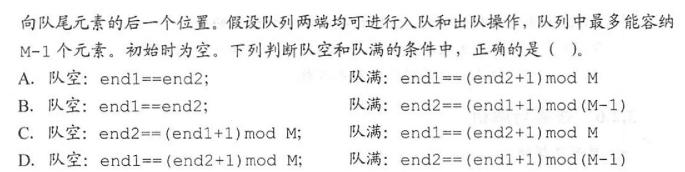
答案依次为 B A
设计队列
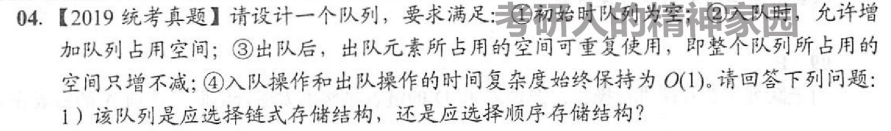
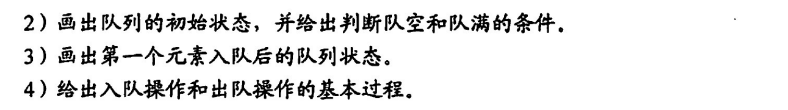
因为要动态增加,一定选择链式存储,由于队列出入队必须 O(1),所以以循环链表储存并设置首位指针
# 栈和队列的应用
栈的常见应用:递归;进制转换;迷宫求解
队列的应用:OS 缓冲区页面置换(FIFO)
# 中缀到后缀表达式的转换
手工上,按照从左往右顺序,依次填入数值,按照运算顺序,依次填入算符,实际上是一个压栈出栈的过程(数栈和符栈)

可以这么看
(b+c)是一个整体bc+,a和d各是一个整体a先和bc+通过*复合得abc+*abc+*又是一个整体,和d由-复合得abc+d-
故选 B
在利用栈模拟转换过程时,总体上保持从左往右的顺序入栈,出栈时,数栈随符号栈的弹出而弹出(一次弹出俩)
符号的出入栈,和栈顶元素比较
- 若优先级高则入栈
- 小于等于则直接运算
- 括号单独处理,当碰到收括号
),依次弹出符号直到弹出(
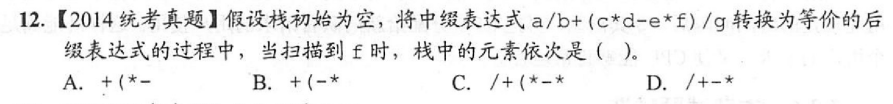
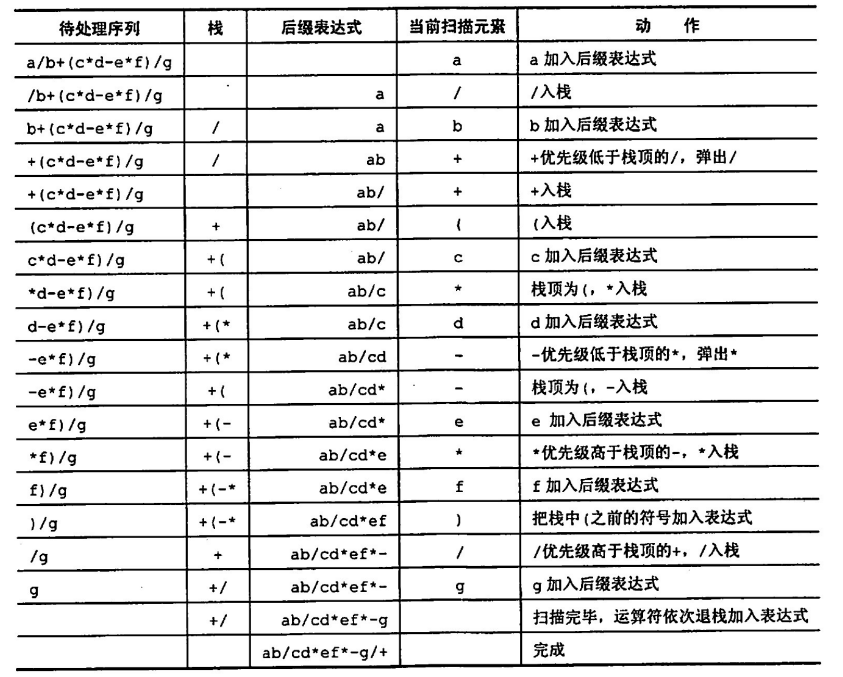
上题选 B,栗子二自己推推,选 A
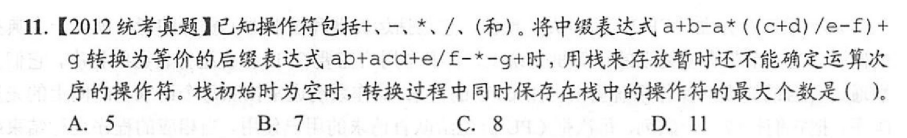
# 递归算法到迭代算法
迭代算法通常效率高于递归算法,因为递归时常有一些重复的操作
递归转迭代的栗子,递归是从高层往简单递归,迭代是从最基本向高层迭代
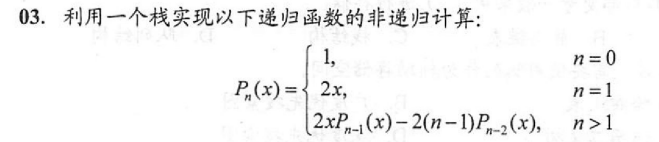
double p(int n, double x){
    struct stack{
        int no;
        double val;
    }s[maxsize];
    int top = -1;
    double v1 = 1, v2 = 2*x;
    for(int i = n; i >= 2; i--){
        top++;
        s[top].no = i; // 记录各个p的下标n,越上层越小,顶层为2,0和1已经单独初始化了
    }
    while(top >= 0){
        s[top].val = 2*x*v2 - 2*(s[top].no-1)*v1; // 按迭代公式求解第3、4...个p的值
        v1 = v2; // 更新v1为v2,v2为v1的下一层
        v2 = s[top].val; // 更新v2为当前层
        top--; // 迭代
    }
    if(n == 0){ // 若n=0,只有一层,v2都不存在
        return v1;
    }
    // 正常情况下,返回最新的迭代结果
    return v2;
}
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# 数组和串
# 矩阵的压缩存储
将多维数组压缩成一维向量储存
对称矩阵和三角矩阵:存储下三角或上三角矩阵,以存下三角矩阵为例
对于元素aij,在下三角矩阵中,其上面有i-1行,共有元素
所以aij是第 k 个元素,其中
因为是存在一维数组中,下标从 0 开始,于是其下标 index 为
注意对于对称矩阵,由
三对角矩阵,形如
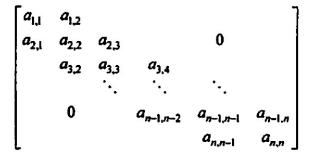
可以注意只有首尾行元素个数为 2,其余均为 3,对于aii,在一维向量中,为第 k 个元素
在一维数组中,下标为
稀疏矩阵:三元组和十字链表
三元组示例(就是一个一维结构体数组)
| i | j | value |
|---|---|---|
| 0 | 0 | 4 |
| 1 | 2 | 6 |
| 2 | 1 | 9 |
# 字符串存储
串的三种存储方式
数组
typedef struct{
	char ch[maxsize];
    int length
}string;
2
3
4
堆分配
typedef struct{
	char *ch;
    int length;
}string;
2
3
4
块链
typedef struct{
	char data[4];
	block* next;
}block;

typedef struct{
    block* head;
}string;
2
3
4
5
6
7
8
# 字符串匹配
# PM 表
partial match table
表示一个字符串的子串公共前后缀的最大长度
- 前缀:指去除尾部元素的任意连续字串
- 后缀:指去除头部元素的任意连续字串
举个栗子,对于串aaab,PM 表求解如下
- 第一个子串
a,无前后缀,pm = 0 - 第二个子串
aa,前缀{a},后缀{a},最长公共缀为a,故pm = 1 - 第三个子串
aaa,前缀{a,aa},后缀{a,aa},最长公共缀为aa,故pm = 2 - 第四个子串
aaab,前缀{a,aa,aaa},后缀{a,aa,aab},最长公共缀为aa,故pm = 2
所以aaab有pm = [0,1,2,2]
# KMP 模式匹配 - next 数组
KMP 就是根据前后缀的重复性,在失配时,合理的移动指针,用已经匹配上的子串
pm 表右移一位即得到 next 数组,如对于上面的栗子aaab,已知pm = [0,1,2,2],则有next = [-1,0,1,2](有时为了方便运算以及公式整洁,整体加一为[0,1,2,3])

选 A
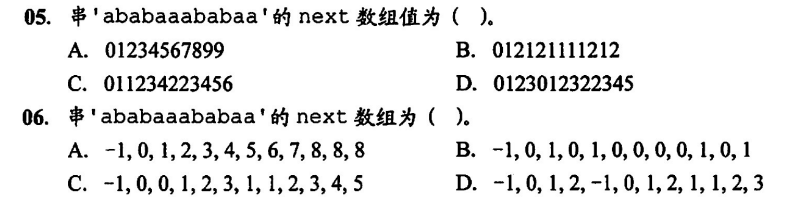
分别为 +1 后的 next 和原始的 next,两个都选 C
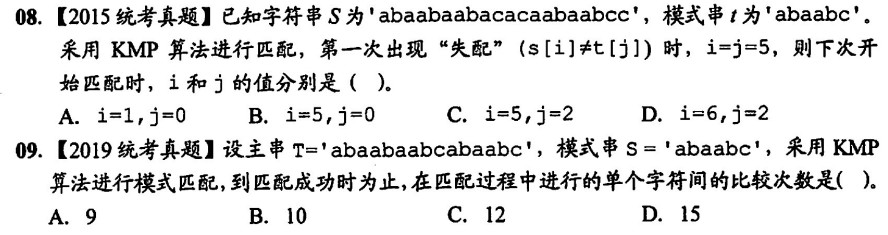
分别选 C B
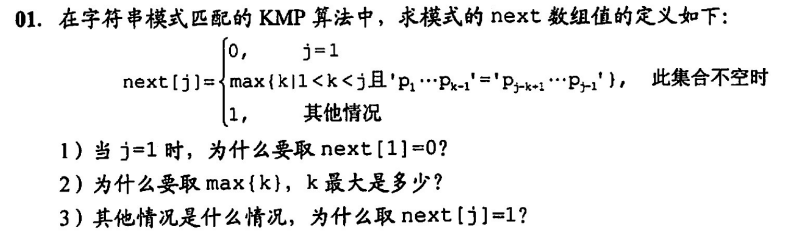
需要完全理解 next 求解过程,可惜
这里 KMP 的下标很怪,不管是 next 数组还是模式(子串)的起始,都默认为 1,对于字串的指针 j 来说,0 只是一个过渡阶段,根本不使用(为了在j==0时同时执行j++; i++减少代码量)
另外模式和 next 独立于主串运行,主串的指针 i 不受 next 的编号和模式的指针 j 影响
只用记住1 <= j,同时指向 next 和模式(子串)
# 优化 KMP - nextval 数组
当失配时,模式的指针根据 next 数组向前移动,若移动到的指针指向的字符,仍为移动前的字符,如ch[5] = 'c',此时失配,移动指针j = next[5] = 3,结果ch[3]还是字符'c',此时一定会再次失配
于是为了避免这种情况发生,采用 nextval 数组,对 next 数组进行优化,消除ch[k] = ch[next[k]]的情况,令 next 值向前递归,即令next[k] = next[next[k]]直到ch[k] != ch[next[k]]
采用图表的方式手动修改 next 为 nextval
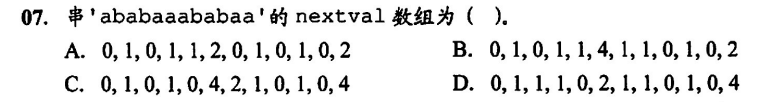
先根据 PM 求解其 next 数组为[0,1,1,2,3,4,2,2,3,4,5,6],然后根据编号列表
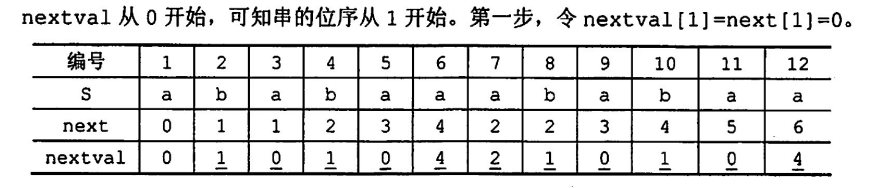
选 C,转化到0,1,0,1,0就可以确定答案了
另外提一嘴:暴力匹配时间复杂度O(mn),KMP 时间复杂度O(m+n),但在实际生产过程中暴力匹配其实可以近似于O(m+n),于是被沿用至今