
 局域网与网络路由
# 局域网和广域网
IEEE(美国电气电子工程师协会)的经典贡献:有关局域网的 802 系列协议
# 局域网
局域网的实现遵守 IEEE802 系列协议,如
- 802.3,以太网(总线型)
- 802.5,令牌网(环形)
- 802.11,无限局域网(星形)
# 802.3 协议
以太网,有线局域网
以太网协议,使用 CSMA-CD 进行访问介质控制,通过广播和 MAC 地址识别进行数据传输
MAC地址长度为 6B,前 24 位表示网卡厂商,后 24 位为网卡编号,都是网卡做出来的时候烧的,唯一
以太网的 MAC 帧格式
- 6 + 6 + 2 + 46~1500 + 4
- 源地址 + 目的地址 + 帧类型 + 数据段 + 校验码(FCS)
最大为 1518B,最小为 64B,这是因为,我们认为有限局域网传输速率为 10Mb/s,争用期为 51.2μs,故
而最大是因为规定以太网 MAC 帧的数据段最长为 1500
各种传输介质下的以太网特征,需要记忆
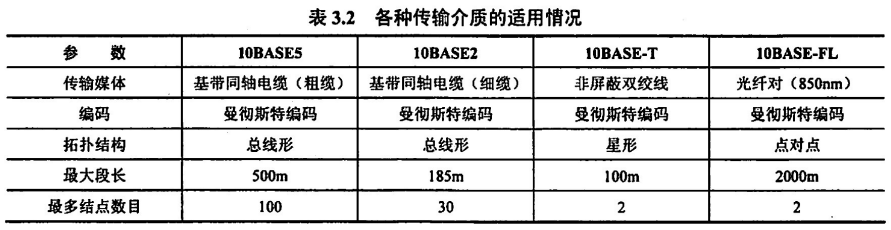
在上述介质中,T 表示双绞线,2/5 数字表示同轴电缆(数字越大电缆越粗,段长越长),FL 表示光纤
其他以太网
- 高速以太网:减少站点之间距离,拉高传输速率,保持最短帧长度
- 吉比特以太网(1Gb/s):可半双工,可全双工,注意在半双工时实际带宽为额定带宽的一半
- 10 吉比特以太网(10Gb/s):只支持双工通信,无冲突,可以双绞线也可以光纤
注意,所有类型的以太网均在同一广播域,这意味着所有信息都在总线上进行广播,广播的对象甚至包括发送信号的站点自身
# 802.11 协议
无限局域网
无限局域网协议,使用 CSMA-CA 进行访问介质控制
| 组成 | |
|---|---|
| BSS | 基本服务集 |
| AP | Access Point,接入点,需要分配 SSID |
| DS | 分配系统,用于连接不同基本服务集 |
| base station | 基站,分为移动的和固定的 |
| ESS | 拓展服务集 |
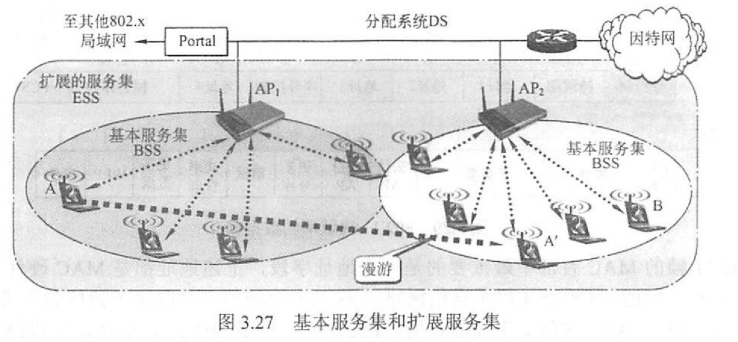
移动基站的漫游:在一个 ESS 中,基站从一个 BSS 漫游到另一个 BSS,其仍属于同一个 ESS,但接入点 AP 发生改变
802.11 首部(共 30 B)的三地址
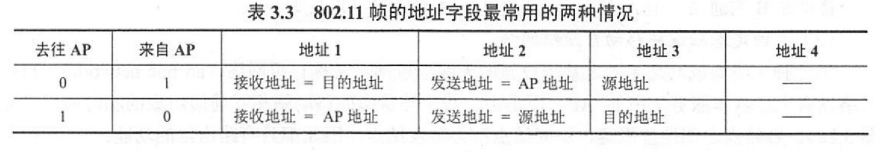
分为to AP和from AP两种,通过两个标志位区分,三地址中,第一个地址始终是发送帧的直接站点地址,第二个始终是接收帧的直接站点地址,第三个
- 若为
to AP,则为最终的目的 MAC 地址 - 若为
from AP,则为发送帧的源物理地址
802.3 帧和 802.11 帧是可以相互转化的,只需要改变首部的一些字段即可,在封装网络层 IP 数据报时,先通过 ARP 协议将其转化为 802.3 帧,再在局域网中封装为 802.11 帧
为什么 802.1Q 使用 CSMA-CA 而不使用以太网的 CSMA-CD 来减少冲突呢?
- 无限局域网的信号弱,碰撞检测(CD)的难度大
- 无限局域网很多站点不能感受到局域网中的所有站点,根本无从进行碰撞检测(这是 CSMA-CD 的必要条件,即不存在隐蔽站)
# 802.1Q 协议
VLAN,虚拟局域网
一个以太网是一个广播域,即使用交换机将以太网分割开,其仍是一个广播域
虚拟局域网(VLAN)协议,在 802.3 以太网 MAC 帧的基础上加入了长度为 4B 的 VLAN 标签构成 802.1Q 帧(最长为 1522),将局域网从逻辑上分割成若干小的广播域
VLAN 既可以划分冲突域,又可以划分广播域(以太网交换机只可以划分冲突域)
虚拟局域网的划分方法,常有三种
- 基于网卡地址(MAC 地址)划分
- 基于网络层地址(IP 地址)划分
- 基于交换机端口划分
# 广域网
广域网是因特网(互联网)的核心部分,自然局域网是因特网的边缘部分,注意因特网可以连接不同类型的网络(如局域网、广域网),显然局域网和广域网是做不到的,这不失为因特网和广域网的一大差别
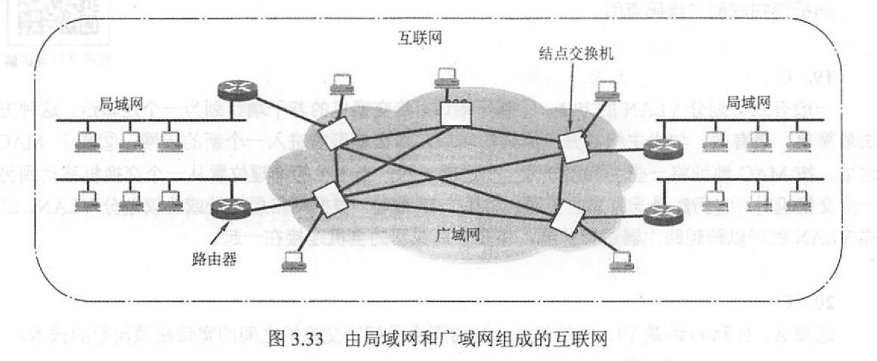
我的理解为,局域网和广域网的复杂网络共同构成了互联网,其中交换机、路由器等设备连接、中转各种网络
相比于局域网,广域网的覆盖范围极大,并且涉及 ISO 网络体系结构的下三层,主要使用的协议在网络层(局域网主要在链路层),这是由网络封装数据时主要所使用的协议决定
广域网解决的重要问题:路由选择和分组转发(同样也是网络层解决的主要问题)
- 都分组转发了,其数据传输一定采用的存储转发式以及分组交换技术
广域网之中,数据最终还是通过比特流传输,一定会经过链路层(和局域网一样,其接收上层的报文,在相应链路层协议下封装成帧,最终通过比特流在物理介质上传输),广域网使用的链路层协议为:PPP 协议和 HDLC 协议
# PPP 协议
Point to Point 协议,是一种使用串行线路通信的、全双工的、面向字节的、有连接的链路层传输协议,应用在直接连接的两个结点的链路上
PPP 基于 SLIP 协议,后者只适用于上层使用 IP 协议的网络层数据在链路层的封装
PPP 协议的内容包括三部分
- LCP:链路控制协议,用于链路连接的建立、销毁等
- NCP:网络控制协议,PPP 协议允许同时采用多种网络层协议,NCP 用以适配不同的网络层协议,为网络层协议建立和配置逻辑连接
- 一种成帧方法,即规定 PPP 帧格式
PPP 的帧格式
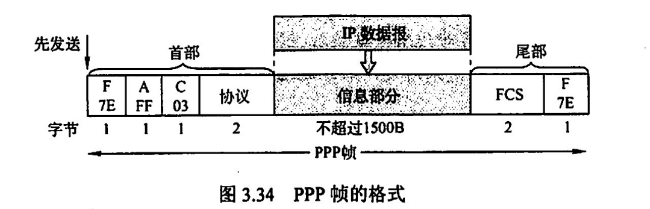
其中 F 为标志字段,标志帧的开始和结尾,A 为地址字段,C 为控制字段,协议字段标明所使用的网络层协议(前面提到了 PPP 可以兼容不同的网络层协议),FCS 为老朋友校验码,这里占 2B
这里明确指出,PPP 帧的信息部分 SDU 就是上一层的 PDU,即 IP 数据报(报文),回顾一下(n-1 表示封装的前一层)
PPP 帧采用首尾字符定界来界定帧,其首尾标志位 7E,即 0111 1110 来表示帧的开始和结束,信息段的 7E 采用转义字符的方式来处理,PPP 帧的转义字符为 7D,则信息段的 7E 则表示为 7D7E
由于 PPP 是点对点的(主机对主机),肯定没有冲突,根本不需要冲突检测/避免,所以没有最短帧限制,自然不需要有信息段大于等于 46B 的限制
可以发现,PPP 帧所有字段都是按照字节来分段,也就是说 PPP 帧的长度一定为整数字节,这也是为什么说 PPP 是面向字节的链路层协议
# HDLC 协议
HDLC 是 PPP 协议的基础
已经很少用了捏,是一种面向比特的协议,采用首尾比特串定界法,使用 01111110 来标志帧的开始和结束,信息段对于连续的五个 1 采用 0 比特填充法(即碰到五个连续的 1,则在其后面填充一个 0),以实现透明传输
# 以太网交换机
Switch
以太网交换机、集线器和虚拟局域网的区别
| 交换机(Switch) | 集线器(Hub) | 虚拟局域网技术(VLAN) |
|---|---|---|
| 隔绝冲突域,不隔离广播域 | 啥也隔绝不了,纯纯的广播 | 既隔绝冲突域,又隔离广播域 |
| 多端口网桥 | 多端口中继器 | 802.1Q 帧 |
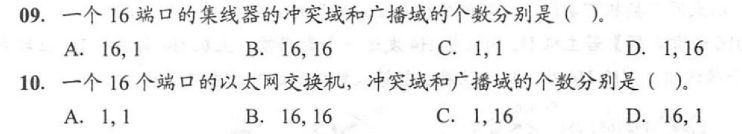
选择 B、D
交换机的带宽:每个端口独占其端口的带宽,交换机的总带宽(总容量)为所有端口带宽之和
- 注意交换机可以是全双工也可以是半双工的,若是半双工的交换机,其总带宽为所有端口带宽和的一半
交换机的自学习算法:维护一个交换表,每当有站点从其相应端口向交换机传入帧时,将其 MAC 地址和对应端口写入交换表,同时根据帧的目的地址先在交换表中寻找对应端口
- 若有,则发送至相应端口
- 若无,则广播除发送端口的所有端口
注意只有传入交换机的站点才写入其端口表项,若已有则更新
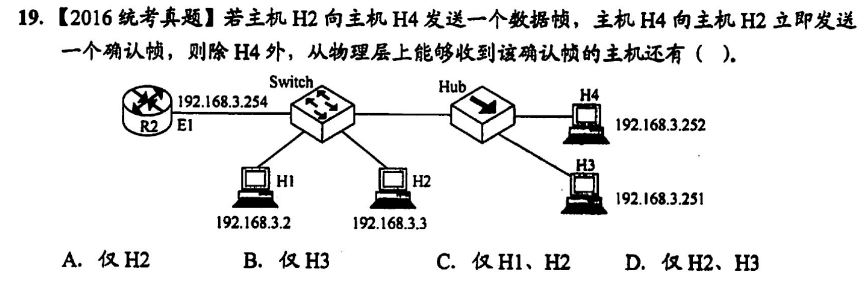
这里选 D,不难看出,这个废物 Hub 啥也不隔离,直接广播所有与其相连的设备(至少在物理上一定是传输过去了,只是会被丢掉),而 Switch 因为 H2 传入过帧,所以在发送确认帧时交换表中有其 MAC 地址对应的表项,直接发送相应端口即可,无需广播
注意这里的交换机的前缀是以太网交换机,是不是意味着还有广域网交换机,这是肯定的,在上面的互联网的概念图中,作为核心部分的各个广域网,就是通过交换机相连接,广域网和局域网通过路由器相连接
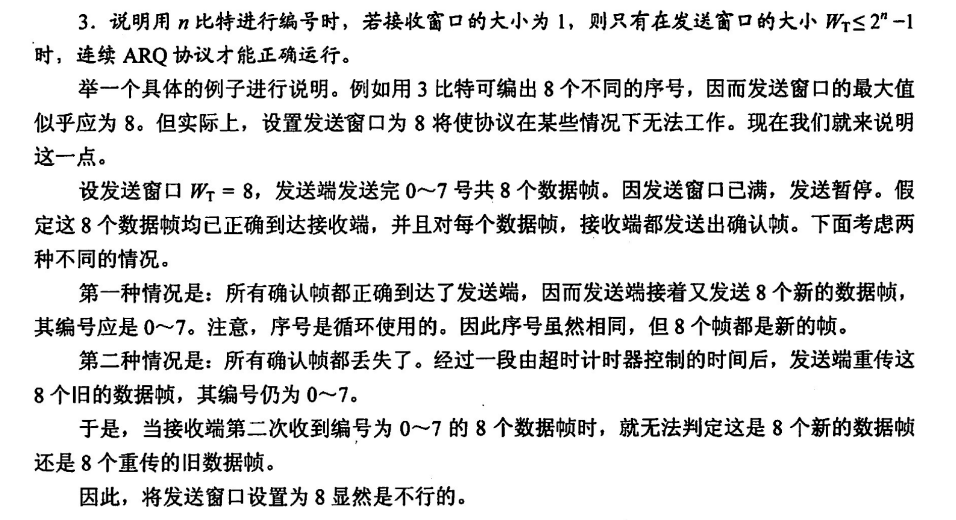
遗留了一个问题,为什么是
# 网络层功能
我对整个网络的传输过程产生了疑问,网络层说是通过相同的 IP 协议统一了下三层的不同网络,如局域网和广域网,但分组在网络层,帧首尾部套在分组的外侧,最终数据以比特流在物理链路上传输,即使不同的网络在网络层识别到所谓统一的 IP 分组,但怎么去拆解不同的帧从而得到这个 SDU 呢
就是说,你通过网络层协议来统一,但网络层协议在数据的内层,在接收时首先是识别不到的(先识别帧再得到 IP 分组),那是怎么通过一个首先识别不到的数据来辨识一段比特数据呢?
整个计算机网络就是一个无向图,涉及一些简单的图算法用于路径选择(路由)
# 连接异构网络
异构网络相连,所谓的统一下三层的不同网络,通过路由器将使用不同下三层协议的网络中继相连接,组成一个大的互联网,这不同于以太网交换机和集线器,这两个东西都只是扩大了广播域,相当于将同一个网络扩展,并没有连接其他网络
# 路由和转发
路由和转发:路由选择和分组转发,后者根据前者的信息进行

# SDN
SDN 基本概念:Software Definition Network,软件定义网络,通过软件控制网络的两个主要功能,即路由和转发,将网络分为两层,控制层和数据层,前者负责路由,采用集中控制的方法,后者负责转发,采用分布式处理(在寻常网络中,二者均为分布式)
- 控制与转发功能分离
- 控制层面集中化
- 接口开放可编程
# 拥塞控制
拥塞控制:由于出现过量的分组而引起网络性能下降的现象称为拥塞,正常来说网络负载线性增加,网络吞吐量也该线性增加,当分组逐渐增加,随着网络负载增加,网络的吞吐量增加缓慢甚至不动,考虑网络已经发生拥塞(被丢弃的分组的数量已经严重影响到了网络性能)
流量控制和拥塞控制的区别:流量控制是点对点的,仅仅对发送端进行流量限制(通过滑动窗口机制),而拥塞控制是网络全局的问题,涉及网络中的所有主机、路由器
拥塞控制的方法:开环控制(预防)和闭环控制(基于反馈)
# 路由算法及协议
每个结点都维护的有一个路由表(结点可以视作为一个路由器),记录去往另一结点的路径和代价(无向无环图)
# 距离向量路由
RIP/OSPF
回顾一下图算法中求解多源最短路径的弗罗伊德(Floyd)算法,遍历所有结点的直接边,通过以下公式更新结点间最短距离
距离-向量路由算法:每个结点将自身的路由表直接发送给相邻的所有结点,结点收到路由表后,通过和弗罗伊德算法一样的更新公式去更新自身的路由表
更新的时机为

向所有相邻结点发送路由表的时机为:每次路由表有所更新后
路由环路(是个啥)的问题:当慢收敛导致路由器收到了无用的路由信息时,很可能发生路由环路
举个栗子


维护这样一张路由表
| 源结点\目的结点 | A | B | C | D | E | F |
|---|---|---|---|---|---|---|
| B | 5 | 0 | 8 | 12 | 6 | 2 |
| D | 16 | 12 | 6 | 0 | 9 | 10 |
| E | 7 | 6 | 3 | 9 | 0 | 4 |
| C | min(11,19,12) | 6 | 0 | 3 | 5 | min(8,13,9) |
故 C 到其余结点的最短路径为 [11,6,0,3,5,8],选 B
再举一个栗子


同样的更新策略,已知
| 源节点\目的节点 | A | B | C | D |
|---|---|---|---|---|
| E | 8 | 10 | 12 | 6 |
和题给路由表,则有
| 源节点\目的节点 | Net1 | Net2 | Net3 | Net4 |
|---|---|---|---|---|
| E | min(9,33,32,28) | min(20,45,42,34) | min(32,28,28,42) | min(44,40,20,30) |
故 E 到 net 的最短距离为 [9,29,28,20],故选 D
# 链路状态路由
BGP
迪杰斯特拉算法(Dijkstra):选取当前结点,更新所有直接相连的结点距离(不相邻距离记为 ∞),选定距离最小的结点作为新当前结点,并认为前一结点距离源的最短路径已被确定(和普利姆算法其实一模一样,只不过目的不同,要求权值和最小)

在链路状态路由算法中,所有结点的路由表是一致的,记录了当前结点到整个网络中其他所有结点的最短路由,每个结点都维护了一个单源最短路径路由表
当当前结点路由表发生改变后,将向网络中除直接连接的所有结点发送它完整的路由表,这一操作叫做洪泛法,就像泛洪一样把路由表狠狠的群发
收到路由表的结点通过迪杰斯特拉算法更新自身到所有节点的最短路径表,即路由表,完成一次更新
# 层次路由
就是把每个网络的路由转发分为两种,即在自治系统内部的路由和自治系统外部的路由(即连通其他路由器的路由)

每个路由器(自治系统)都知道自身区域如何把分组转发到目的地的细节,但对其他区域的内部结构一概不知
# 路由协议
# RIP
应用层协议,RIP 信息通过 UDP 数据报在各路由器之间进行传输,将自身结点到所有结点的单源最短路径传输给相邻的路由器结点,当路由器收到来自相邻结点的包含 RIP 数据的 UDP 数据报后,将根据相邻结点的单源最短路径更新自己到任一结点的单源最短路径,更新规则如下
- 当当前路由表中没有到某一结点的表项,而收到的 UDP 数据报表中存在,直接写入当前路由表,并且将路径长度 +1
- 当当前路由表中存在到 u 的表项,假设长度为 n,但收到的路由表到 u 的距离为 u-2,则更新当前路由表到 u 的表项为收到的那一条,并且长度重写为 n-1
- 其余情况不做改变
可以发现,RIP 协议是通过相邻结点的单源最短路径去构造自身的单源最短路径的过程(跳数最少),当距离 >=16 时,我们认为结点不可达
RIP 协议在网络状况差的情况下有可能出现慢收敛问题,且开销随结点数增加(网络规模扩大)不断扩大,所以一般适用于较小的网络
# OSPF
网络层协议,OSPF 数据通过 IP 分组在路由器间传输,通过洪泛法,将自身结点到达相邻结点的距离发送给每一个结点,每一次发送,每一个结点都将根据 Dijkstra 算法通过每条边的距离以及该结点的可达性更新自身已知的可达结点的最短路径
- OSPF 采用 Hello 分组来保持和邻居的连接
第一次迭代,每个结点将只发送和自身直接相邻的结点的距离给剩余结点;第一次更新,每个结点将获得和自身一次间接相连的所有结点的最短路径
以此类推,在不断发送的过程中,结点将不断获取距离自身更远的结点的最短路径距离,以此构造一张统一的路由表
- 为了减小洪泛法的代价,OSPF 还将同一网络按照层次结构分为不同的区域,最上层的称为主干区,在区域内执行洪泛(区域种类增多,传输更复杂)
不同于 RIP,OSPF 不存在慢收敛问题,适用于较大的网络
另外,OSPF 的路径权重并不是简单的跳数(代价最低),这可以根据相邻结点的传输速率动态调整,也给了网络最优路径判断更灵活的选择
# BGP-4
网络层协议,BGP 信息通过 TCP 连接在网关路由器之间传输,每次传输的数据为路由的完整过程,即整条路径(RIP 和 OSPF 都是传输基于下一跳的路由信息)
每个自治系统(AS)维护一个 BGP 发言人,各自治系统通过 BGP 发言人通过 TCP 连接传输 BGP 协议信息构造路由
# 路由器
网络层设备,是一个多端口网桥,是下三层中唯一可以分割广播域的设备,为什么网桥不可以呢?他他妈就一个端口,分割个毛线,想分割起码得两个吧
- 想减缓广播风暴:加路由器
而中继器、交换机更加不能分割广播域,由这二者连接的设备仍然属于同一局域网,在进行 MAC 帧传输时,将广播到局域网中的每个主机
路由表和转发表,后者基于前者
路由表
create table routing_table(
    int(32) dist,
    int(32) mask,
    int(32) `next`,
    varchar port
);
2
3
4
5
6
转发表
create table routing_table(
    int(32) dist,
    varchar port
);
2
3
4
为什么没有距离选项?根据题意自行添加