
 数字特征、大数定律和中心极限
# 离散随机变量数学特征
# 数学期望
一维离散随机变量得数学期望定义:数学期望即所有值乘以其发生概率之和
其中P(i)为概率;Value(i)为值
统计意义:反映了随机变量所有取值的中心位置
性质
- 对于常数 c,E(c) = c,因为默认常数概率为 1,故 E(c) = 1xc = c
- 对于随机变量 X,E(cX) = cE(X),其中 C 为常数
对于随机变量函数f,在得到概率分布表后按照同一步骤(即值、概率相乘求和)求出数学期望
举个栗子
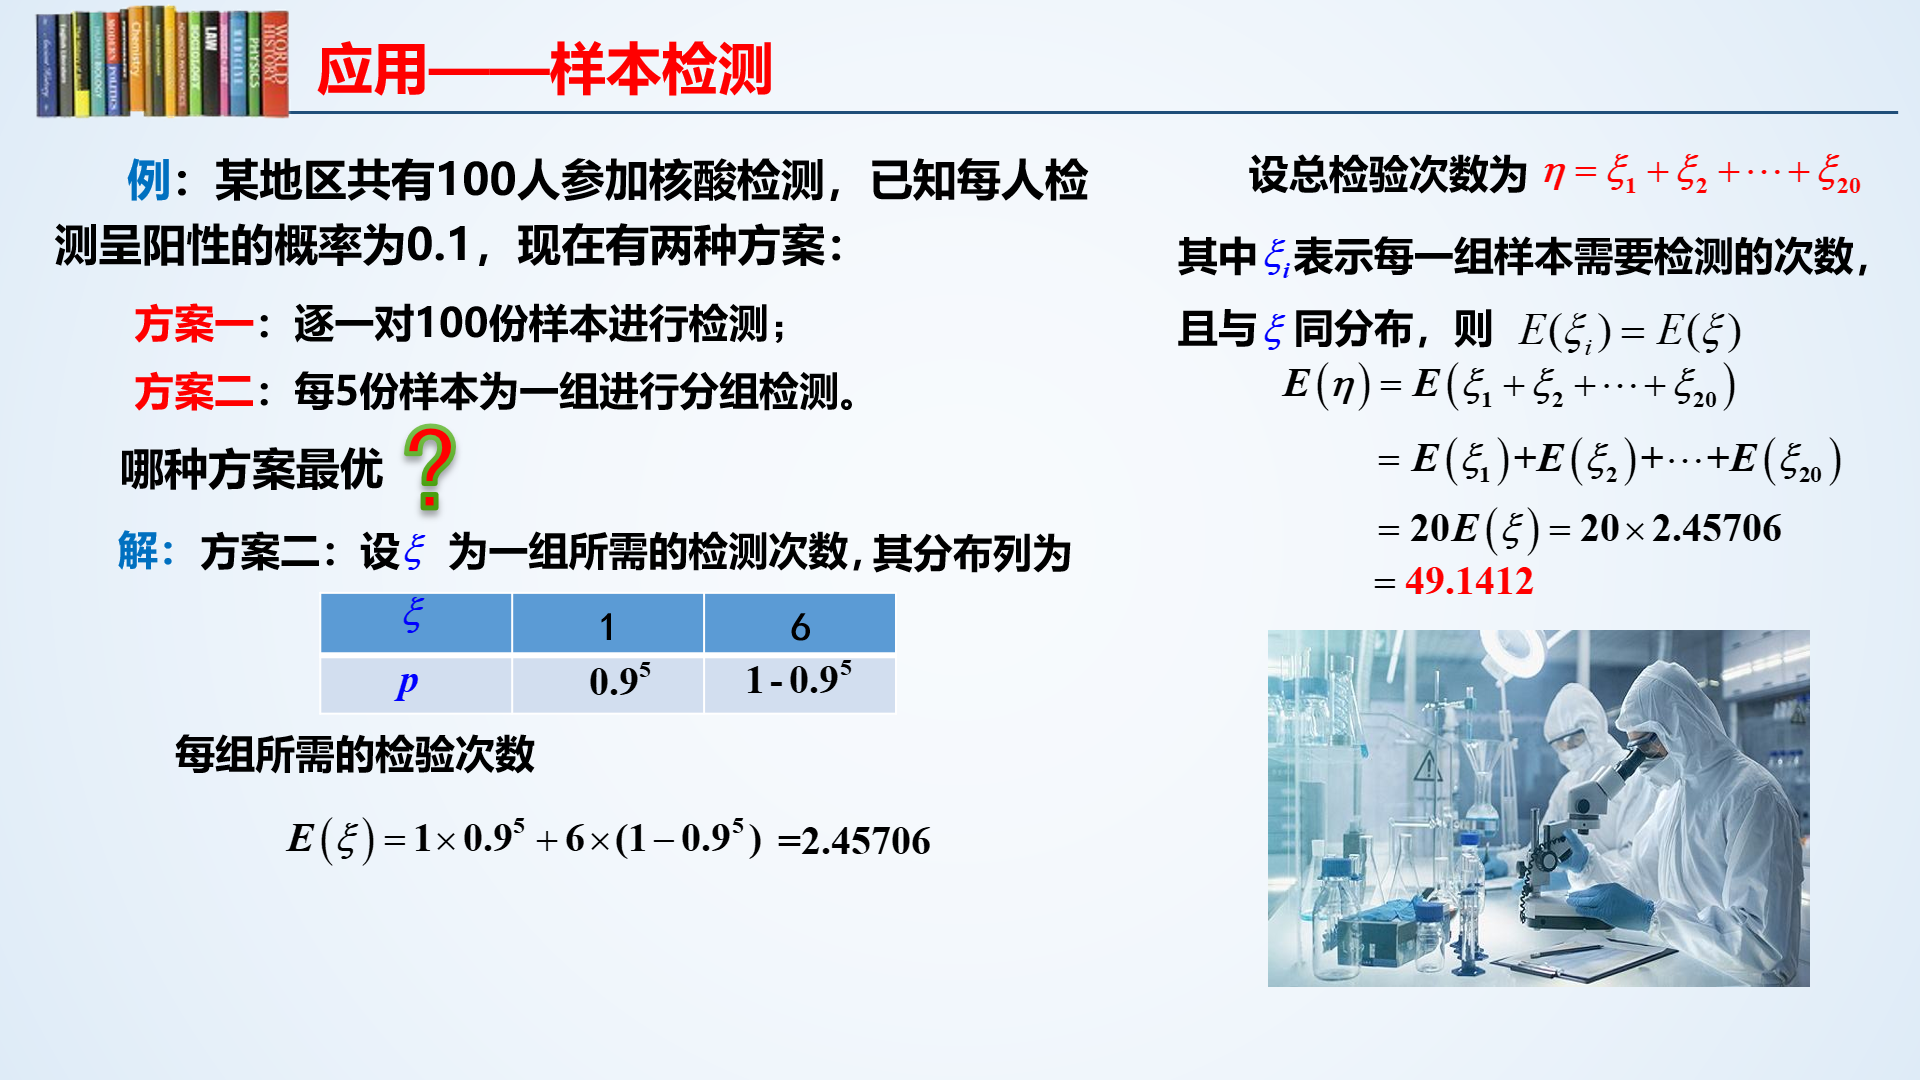
抓住代价:在这里是检测数量,方案一固定为100次,方案二不固定,五人一检,阳性则每人依次检测,阴性则略过
明确取值:在方案二中,每组检测次数取值可能为1或6,根据题目已给条件求出各自概率,再按比例扩大范围
这里有一个分组的问题,一开始没想到
# 方差和标准差
方差:差距的平方的期望
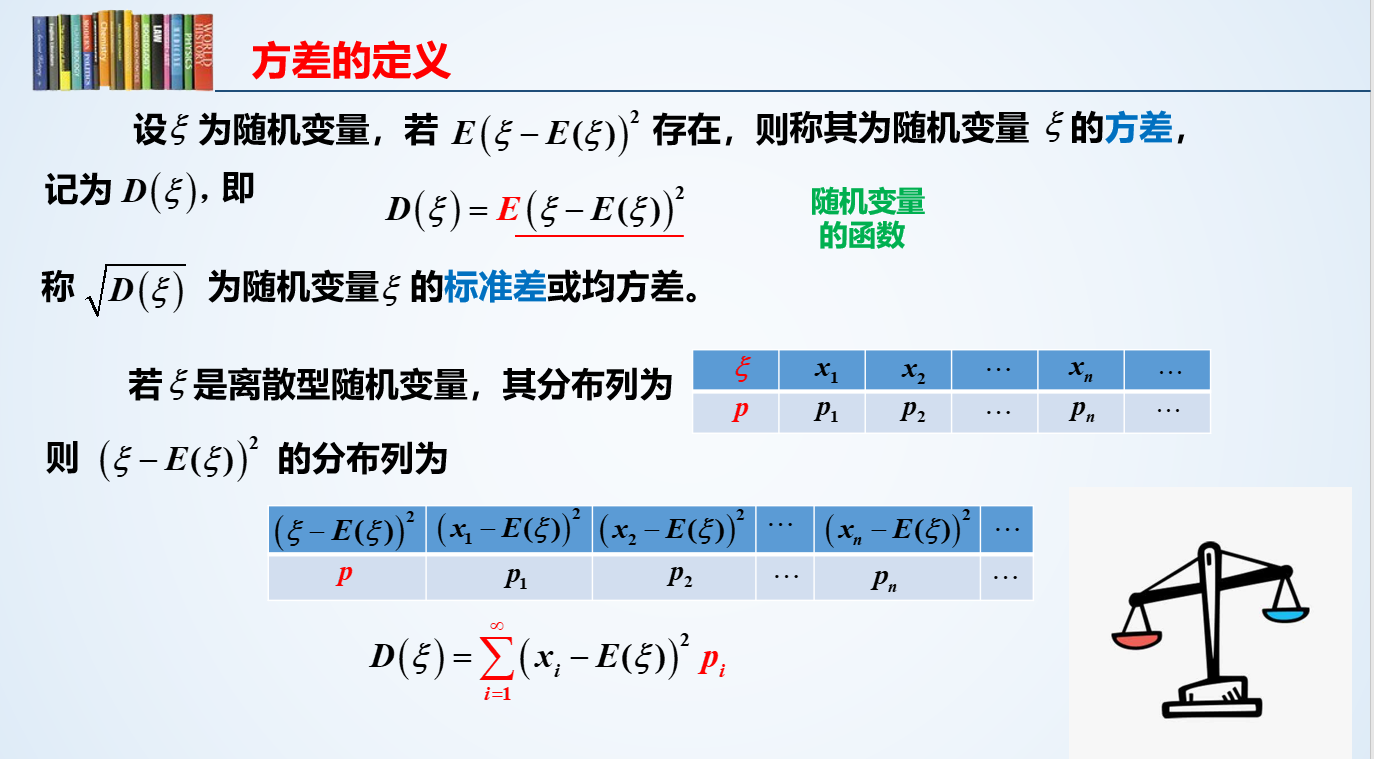
方差开根即为标准差
先求出一维概率分布的数学期望,用
(xi-期望)的平方作为新的值,xi的概率作为这个值的概率,组成一个新的一维概率分布这个新概率分布的数学期望即为原概率的方差,记为
D(X)
方差体现了随机变量围绕期望的偏离程度,方差越小,说明分布越集中,越大说明分布越分散(常用于判断产品优劣)
性质
- 常数的方差为0,即
D(c) = 0,毫不偏差(常数拥有概率为1,偏差为0的特点) D(cX) = c²D(X),常数开出来要平方D(X+Y) = D(X)+D(Y),和变量的方差等于变量的方差和,前提是变量X,Y相互独立
常见概率分布的方差
| 分布 | 参数 | 数学期望 | 方差 |
|---|---|---|---|
| 两点分布 | 0<p<1 | p | p(1-p) |
| 二项分布 | n>=1, 0<p<1 | np | np(1-p) |
| 泊松分布 | λ>0 | λ | λ |
| 几何分布 | 0<p<1 | 1/p | (1-p)/p² |
# 随机变量函数的数学期望
对于一维随机变量 X,已知
| X | -2 | 0 | 1 | 3 |
|---|---|---|---|---|
| P | 1/3 | 1/2 | 1/12 | 1/12 |
对于二维随机变量 X/Y,已知
| X/Y | 0 | 1 |
|---|---|---|
| 0 | (1-p)^2 | p(1-p) |
| 1 | p(1-p) | p^2 |
求得E(X+Y),将f(X+Y)的概率分布表列出,用一维的办法解即可
| f | 0 | 1 | 2 |
|---|---|---|---|
| P | (1-p)^2 | 2p(1-p) | p^2 |
# 连续随机变量数字特征
# 数学期望
回忆以下离散型随机变量的数学期望:概率和值的乘积的和
连续型随机变量的数学期望
即对xp(x)在实数范围内积分,这很合理,就是值*概率的和,若该积分不为正无穷,则称离散型随机变量数学期望存在,为这个积分结果
常见连续型随机变量的数学期望:
1、均匀分布X~U(a,b)的数学期望为(a+b)/2(区间中间)
2、指数分布
3、正态分布X~N(u,v^2)
连续型随机变量函数的数学期望:
对于普通函数f(x),将其自变量换为一个连续型随机变量Z,那么f(Z)的数学期望为:∫(-∞,+∞) f(x)p(x)dx
- 只改变值,概率不变,所以只将积分项中
x换为f(x)
二维连续型随机变量函数的数学期望:
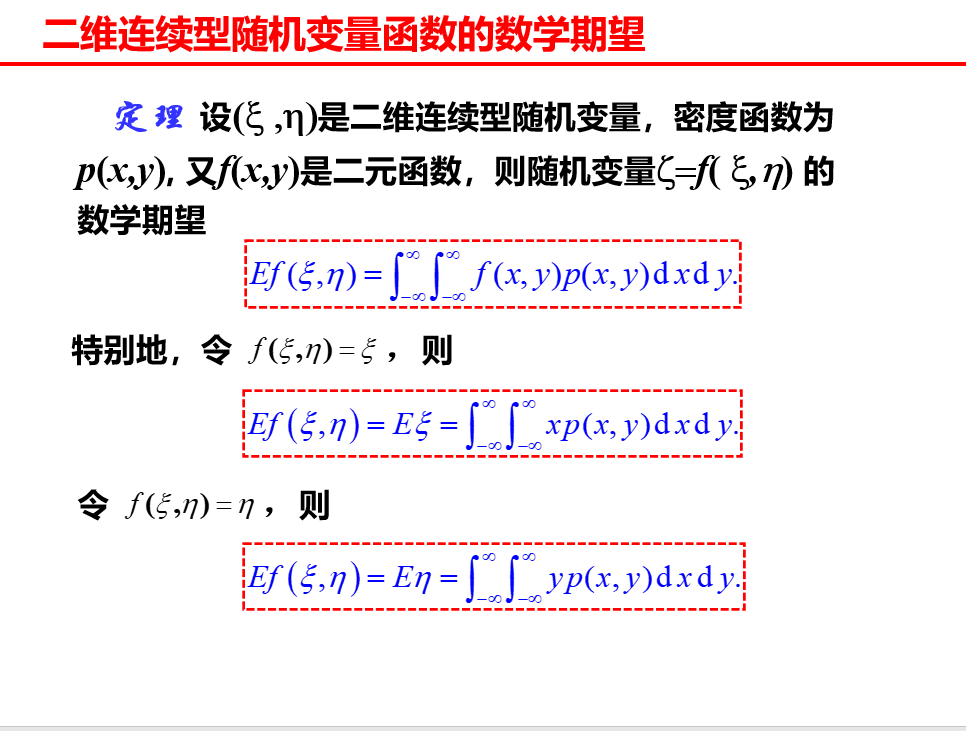
性质:基本与离散型随机变量期望性质一致
- 当随机变量取值有限,必有期望,且期望大于下限小于上线
- 常数的期望为常数自身
E(k1X+k2Y) = k1*E(X)+k2*E(Y),其中k1,k1为实数,X,Y为连续型随机变量- 若连续型随机变量
X,Y相互独立,则E(XY) = E(X)E(Y)
# 方差
计算:D(X)=E((X-EX)^2)
在这里构造一个函数:
用求连续型随机变量函数的方法求方差
即
化简可得
常见连续型随机变量的方差
| 分布 | 参数 | 期望 | 方差 |
|---|---|---|---|
| 两点分布 | 0<p<1 | p | p(1-p) |
| 二项分布 | n>=1,0<p<1 | np | np(1-p) |
| 泊松分布 | λ>0 | λ | λ |
| 几何分布 | 0<p<1 | 1/p | (1-p)/p^2 |
| 均匀分布 | a<b | (a+b)/2 | (b-a)^2/12 |
| 指数分布 | λ>0 | 1/λ | 1/λ^2 |
| 正态分布 | u,v>0 | u | v^2 |
性质
- 常数的方差为0
D(cX) = c^2 D(X)- 对于相互独立的随机变量
X,Y,D(X+Y) = D(X)+D(Y)
# 切比雪夫不等式
之前也提到过,方差越大,一般来说数据离期望会较远,方差越小则反之
切比雪夫不等式使用严格的数学公式规范这种直觉,设随机变量X期望为E(X)=u,方差D(X)存在,则
其中ε为任意正数
# 协方差与相关系数
对于二维随机变量(u,v),协方差反应u,v之间的联系
定义协方差为
展开计算可得
性质
交换律:
Cov(u,v) = Cov(v,u)数乘:
Cov(au,bv) = abCov(u,v)分配律:
Cov(u1+u2,v) = Cov(u1,v)+Cov(u2,v)和方差的关系:
D(u+v) = D(u)+2Cov(u,v)+D(v),当u,v独立时,Cov(u,v)=0,自然D(u+v)=D(u)+D(v)
相关系数
- 相关系数是随机变量间线性关系强弱的一个量度,当
|p|越大,两随机变量线性关系较密切,|p|越小,线性相关程度较差,当p=0,二者线性无关 - 值域为
[-1,1] - 当
p=1,两个随机变量正线性相关,当p=-1,二者负线性相关
协方差也可以表示为
变量和的方差可以表示为
当线性无关,即
注意,独立一定线性无关,但线性无关不一定相互独立,二者是两个不同的概念
# 大数定律
研究大量的随机对象,常常采用极限的形式,由此导致对极限定理的研究
大量随机事件中结果存在一定的稳定性
# 伯努利大数定律
频率是概率的反应,观察次数增加,频率将逐渐稳定、靠近概率,我们用严格的数学公式规范这种描述
其中un为n次实验中事件发生的次数,n自然为总试验次数,p为这个事件的发生概率,ε为一个极小的正数
- 上式也就表明当实验次数趋近于无穷时,频率将无限逼近概率
由伯努利大数定律可以推导得大数定律的定义:
设(ξ1,ξ2,...,ξn)是随机变量序列,如果存在常数序列(a1,a2,...,an),使得
则称随机变量序列{ξi}服从大数定律
# 切比雪夫大数定律
由大数定律的定义推导而来,将常数序列该换为随机变量数学期望的平均值
要求每个随机变量均具有方差且各自独立,并且方差均有同一上界,即
切比雪夫大数定律
复习一波切比雪夫不等式:设随机变量X期望为E(X)=u,方差D(X)存在,则
其中ε为任意正数
# 马尔可夫大数定律
形式上于切比雪夫大数定律一样,但解除了更多的条件限制
若对于随机变量序列(ξ1,ξ2,...,ξn),有
则有
注意切比雪夫大数定律和马尔可夫大数定律均要求随机变量具有方差
# 辛钦大数定律
对于独立同分布的随机变量序列(ξ1,ξ2,...,ξn),有
随机变量的算术平均值将逼近他的数学期望
# 中心极限定理
如何研究一个由大量相互独立且均匀大小的随机变量相加而成的随机变量的概率分布情况
# 林德贝格-勒维中心极限
对于独立同分布的随机变量序列(ξ1,ξ2,...,ξn),则
满足标准正态分布
例题:对于一个学生而言,来参加家长会的家长人数是一个随机变量。设一个学生无家长、1名家长、2名家长来参加会议的概率分别为0.05、0.8、0.15。若学校共有400名学生,设各学生参加会议的家长数相互独立,且服从同一分布
求参加会议的家长数超过450的概率?
解:设ξk为第k个学生来参加家长会的家长数,由题意可得
| ξ(k) | 0 | 1 | 2 |
|---|---|---|---|
| p | 0.05 | 0.8 | 0.15 |
易得数学期望
可得方差
由林德贝格-勒维中心极限定理
其中ξi的和实际上就是整个班的到场家长人数,由中心极限定理可知上述式子是满足标准正态分布的,即A~N(0,1)
所以
# 棣莫佛-拉普拉斯中心极限
二项分布收敛于正态分布
对于独立同分布的随机变量序列ξ=(ξ1,ξ2,...,ξn),若每个随机变量ξi均服从B(1,p),即为发生概率为p的0-1分布
由林德贝格-勒维中心极限定理:下式服从标准正态分布
代入0-1分布的性质,可得
A服从标准正态分布,即A~N(0,1),自然有
注意这里每个随机变量服从的是0-1分布,但对于整个随机变量序列,实际上服从的是一个二项分布,即ξ~B(n,p)
- 正态分布是二项分布的极限分布
例题:对于一个学生而言,来参加家长会的家长人数是一个随机变量。设一个学生无家长、1名家长、2名家长来参加会议的概率分别为0.05、0.8、0.15。若学校共有400名学生,设各学生参加会议的家长数相互独立,且服从同一分布
求一名家长参加会与的学生数不超过340的概率?
解:记ξ为带一名家长参加会议的学生数量,易得ξ~B(400,0.8)
由棣莫佛-拉普拉斯中心极限定理(假设400已经够大了),可得
满足标准正态分布,所以